使用ChipWhisperer-Nano进行故障注入
2026.10.14:更新ing
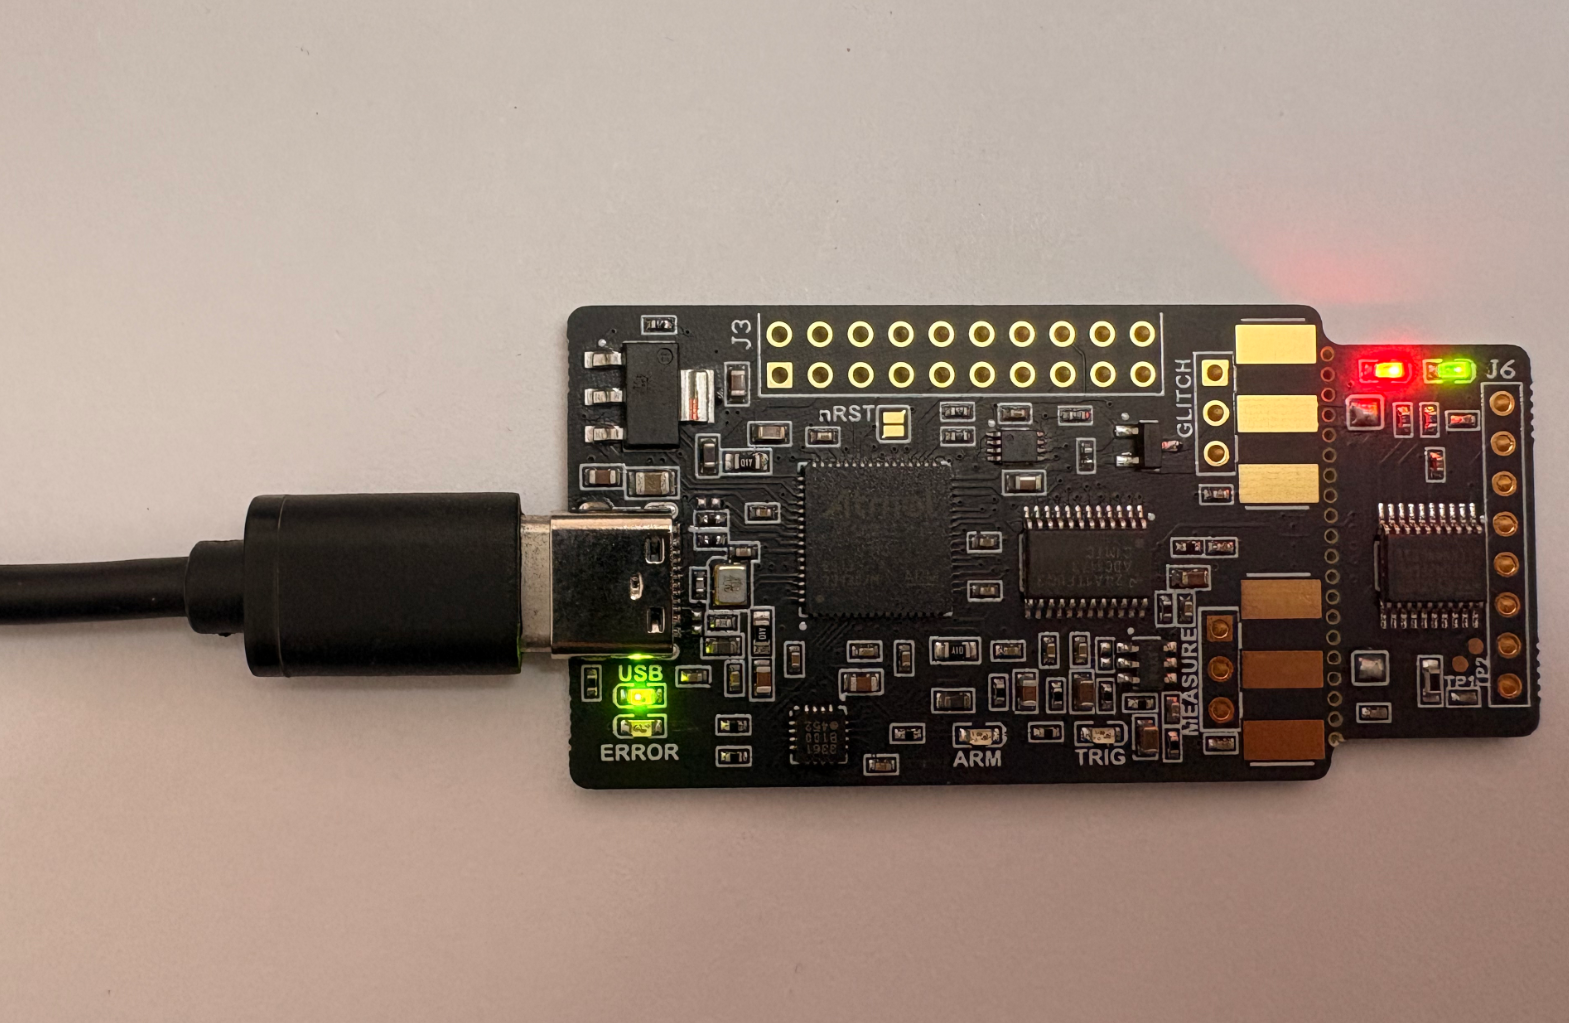
实物:
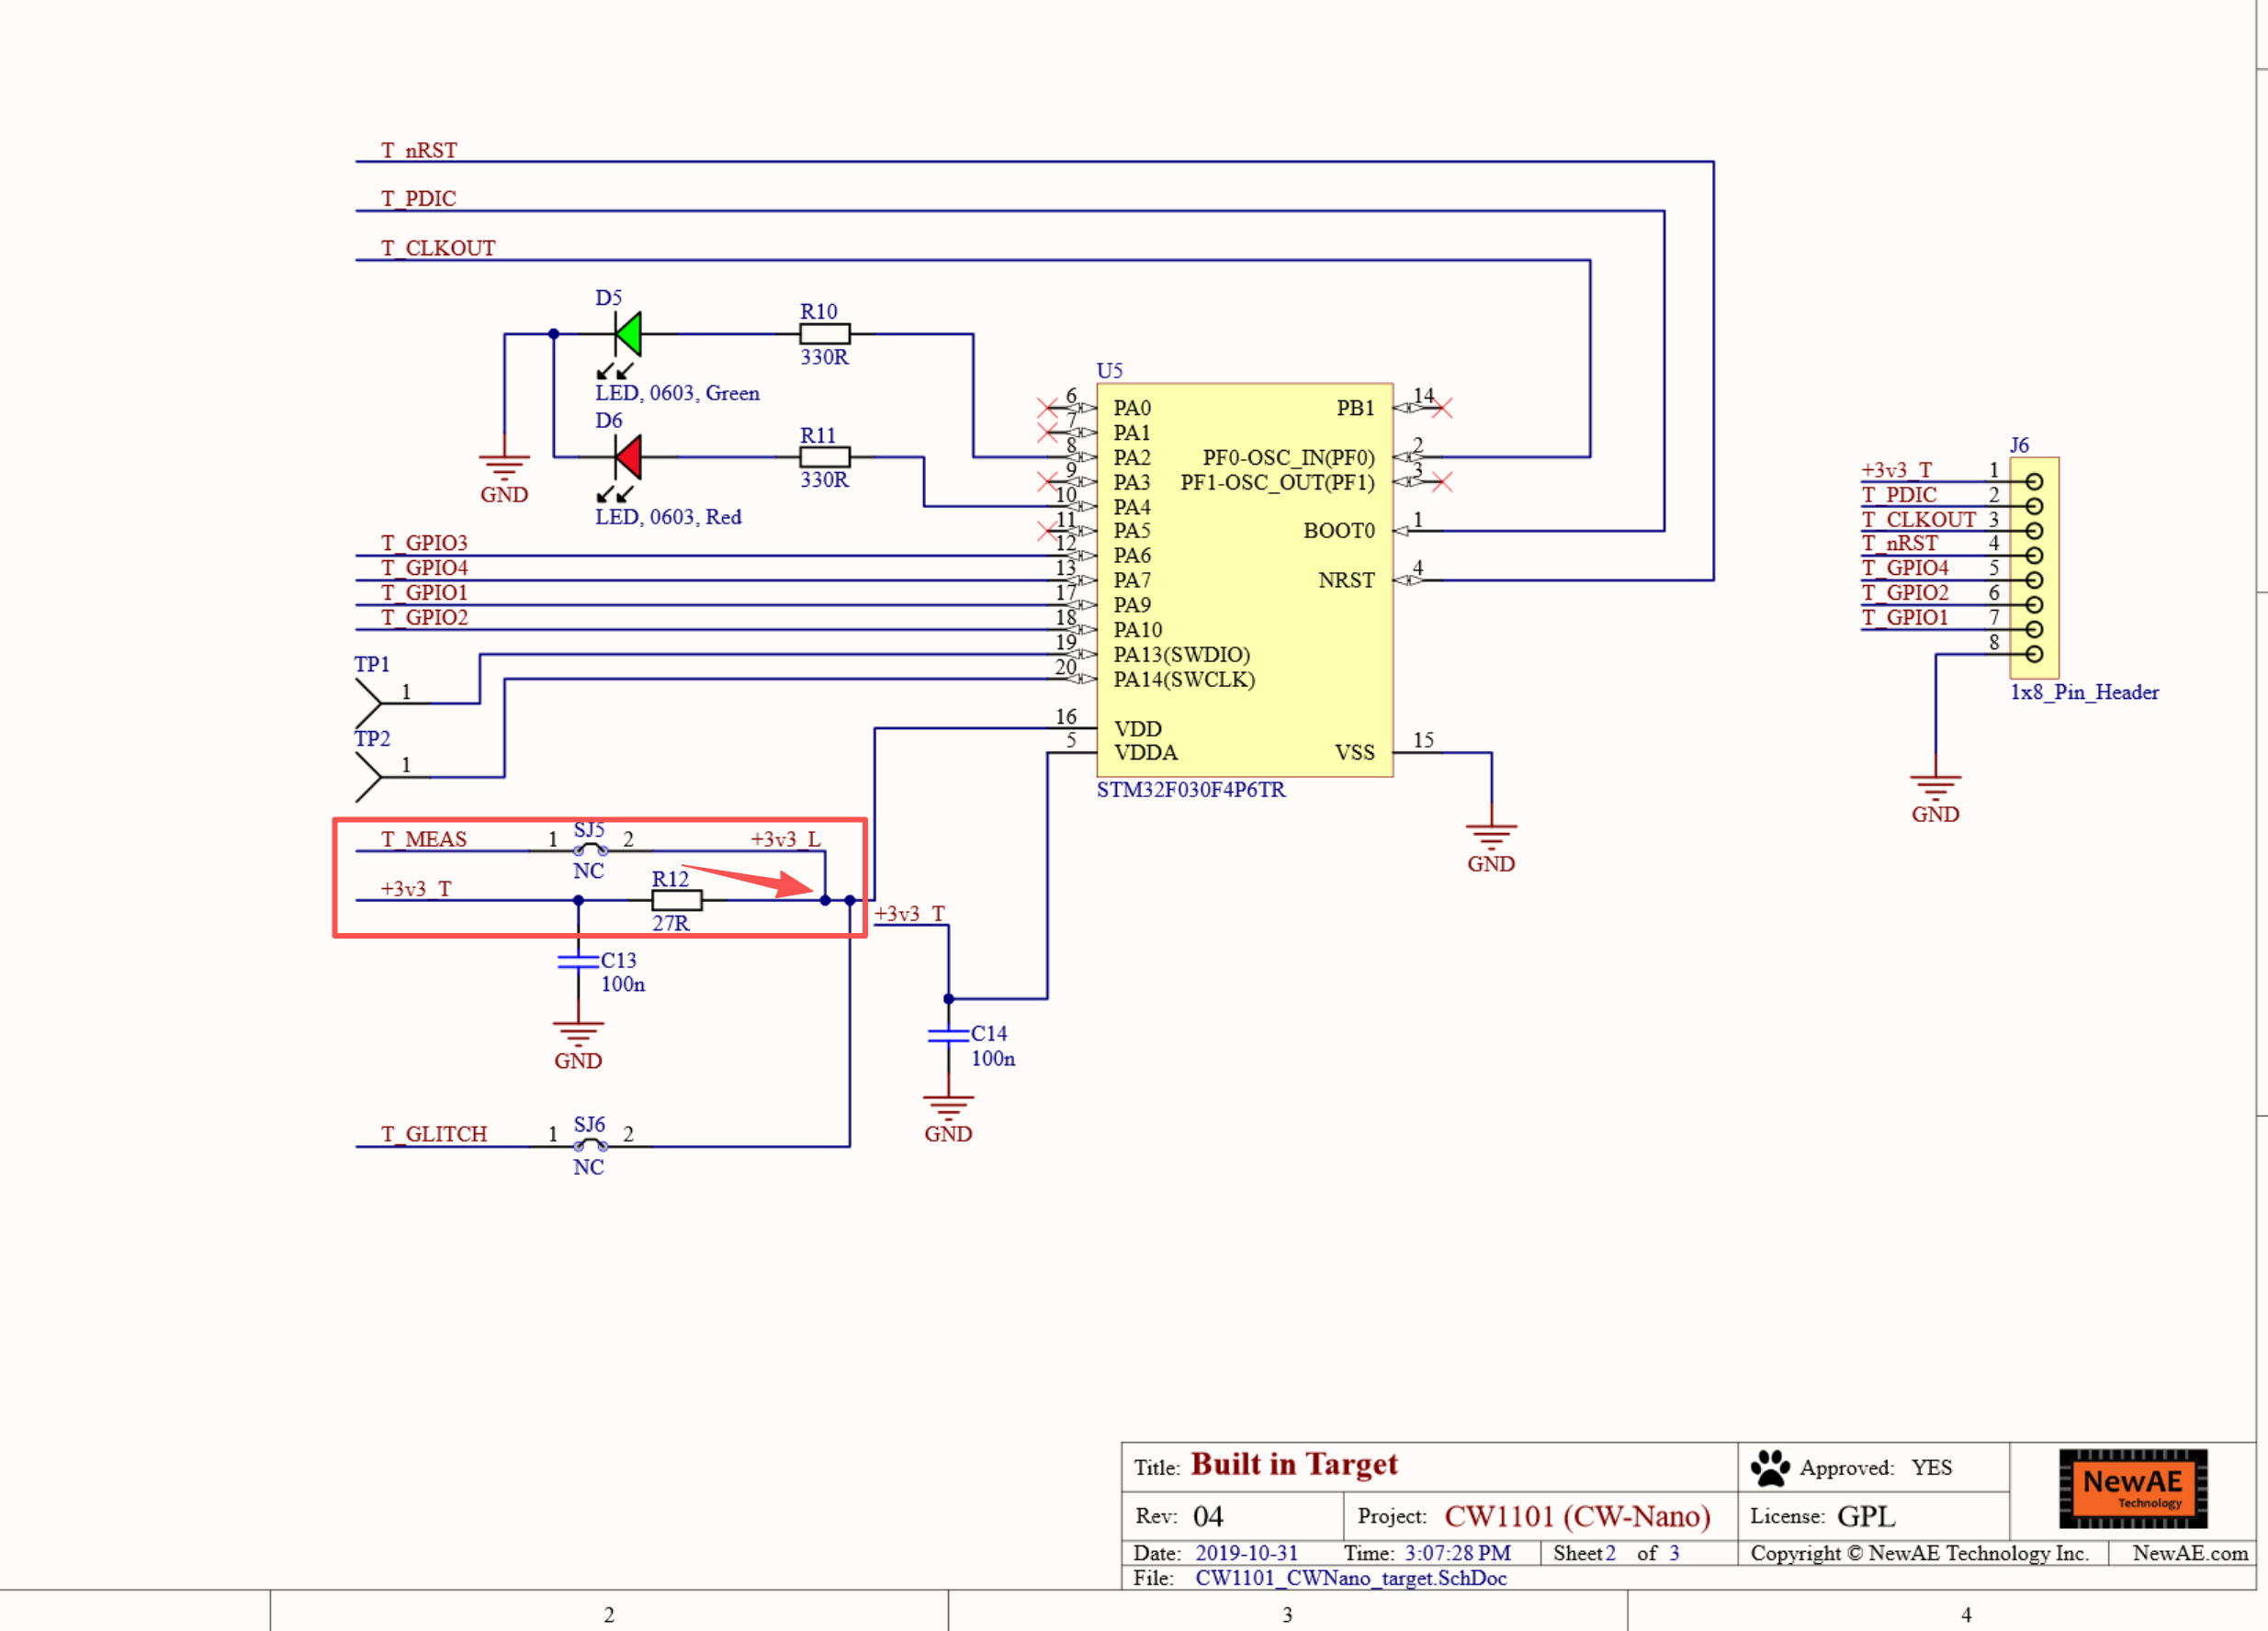
下图为内置目标原理图,测量点在箭头位置。
目标供电路径中的采样电阻产生电压变化,Nano 的模拟输入电路负责测量它。
观察电源和电压的变化:
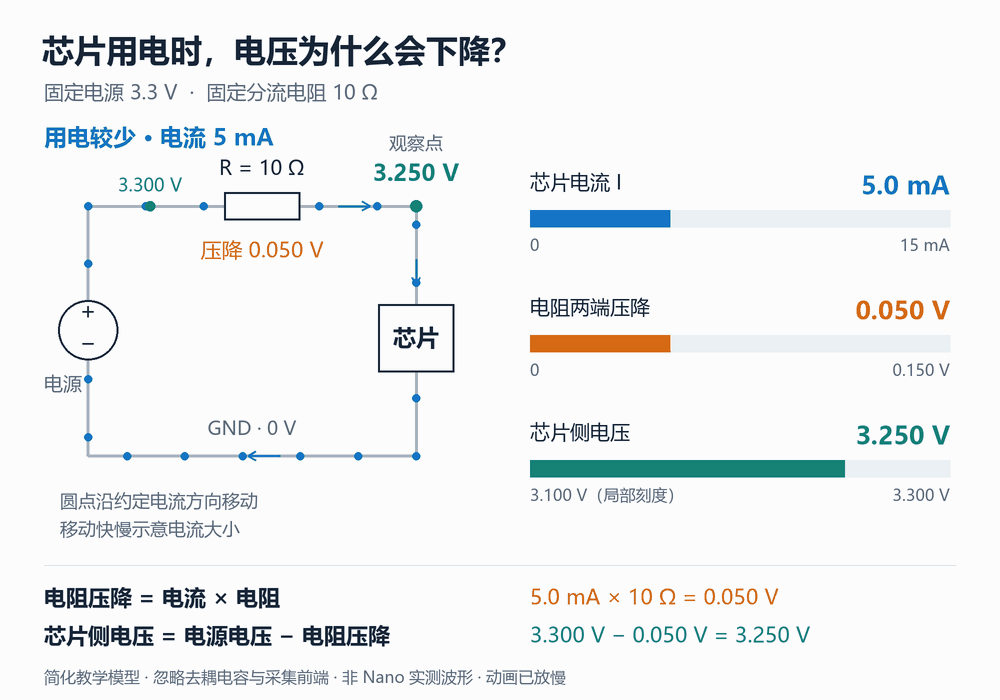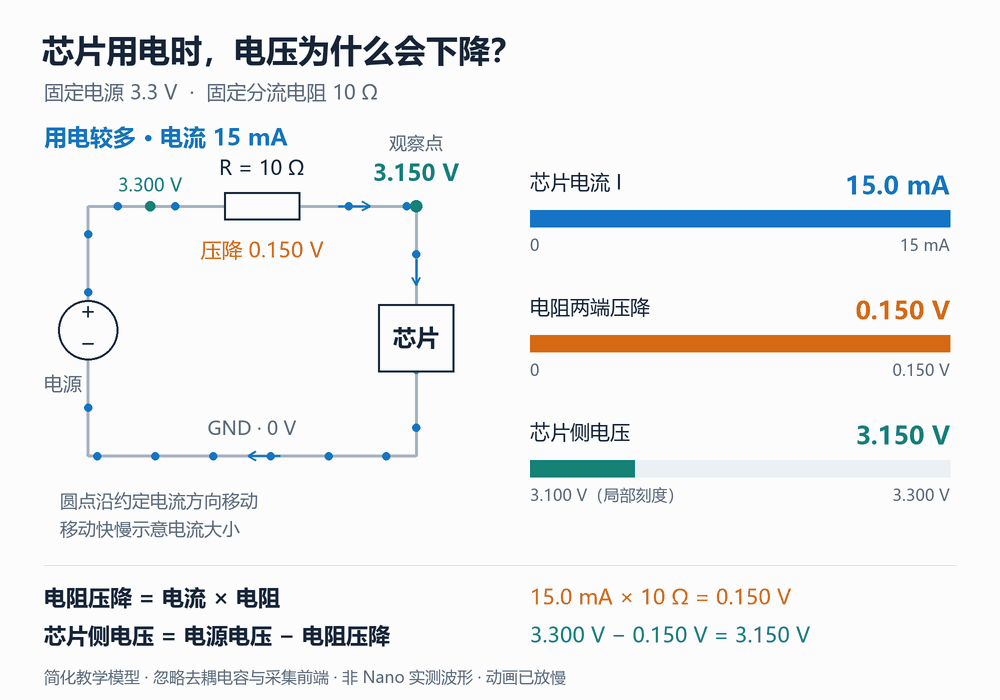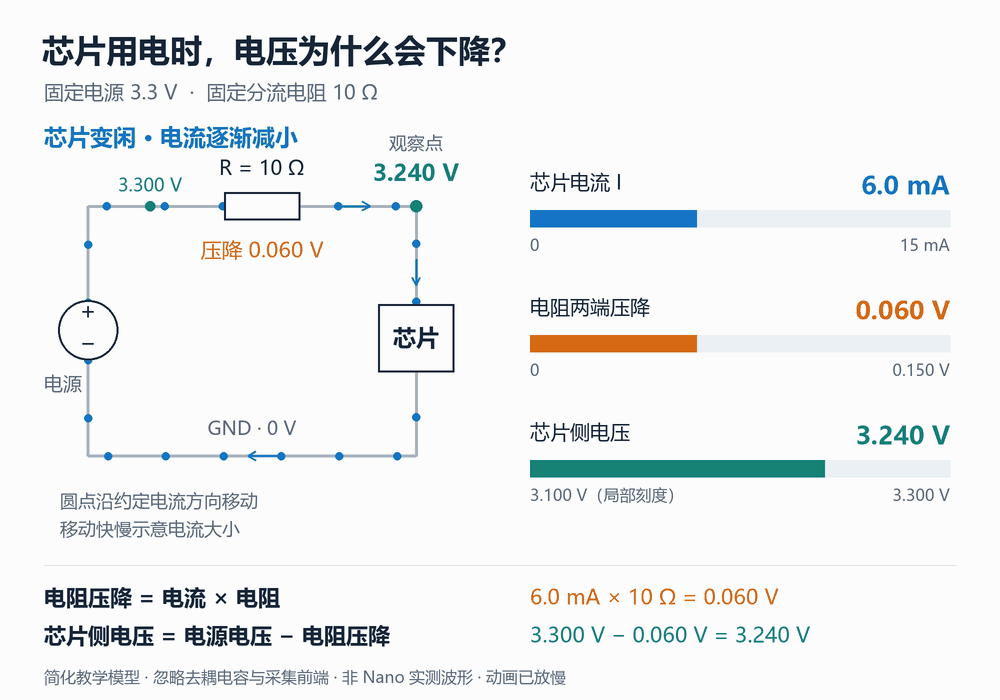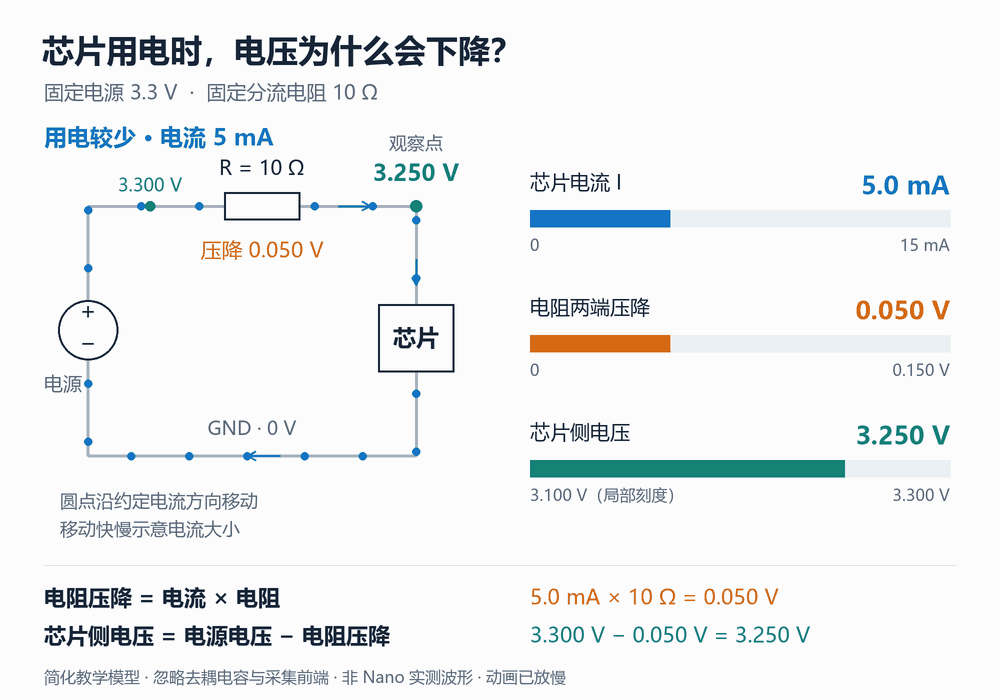
只不过Nano会有个反相放大器把下降翻转为上升,所以ADC的度数还是符合常理的。
波形数值 = 原始 ADC 数值 / 256 - 0.5但是测量到的ACD度数不能直接代表当时的电压。正常来说,直接测量该点的电压为:
稳定的 3.3 V 电源 ── 10 Ω 分流电阻 ── 芯片
                                       ↑
                                在这里直接测电压

如果测到 3.2 V:
电阻压降 = 3.3 − 3.2 = 0.1 V
电流     = 0.1 ÷ 10 = 0.01 A = 10 mA
芯片功率 ≈ 3.2 × 0.01 = 0.032 W

如果另一次测到 3.1 V:
电阻压降 = 3.3 − 3.1 = 0.2 V
电流     = 0.2 ÷ 10 = 0.02 A = 20 mA
芯片功率 ≈ 3.1 × 0.02 = 0.062 W
在这个简化例子里,确实能通过电压比较出功率。前提是电源电压、电阻值已知,且通过电阻的电流就是芯片电流。
但 Nano 实际采集的链路多了几个环节:
芯片供电节点的电压
        ↓
交流耦合:去掉直流成分,主要保留变化
        ↓
反相放大、加入适合 ADC 的偏置
        ↓
ADC 转换成数字
        ↓
软件归一化后画图
对应 Nano:想观察的是芯片执行运算时产生的细小、快速的电流变化。交流耦合让这些变化更容易被放大观察,但也因此丢失了用于计算绝对电流、总功耗的直流水平。
翻译了ChipWhisperer官方文档和Jupyter教程。
实验一:侧信道分析 101
2.1A:不同指令的功耗差异
芯片执行程序时,耗电电流会发生细微变化;Nano 把这些变化转换成电压,再高速采样成数字。
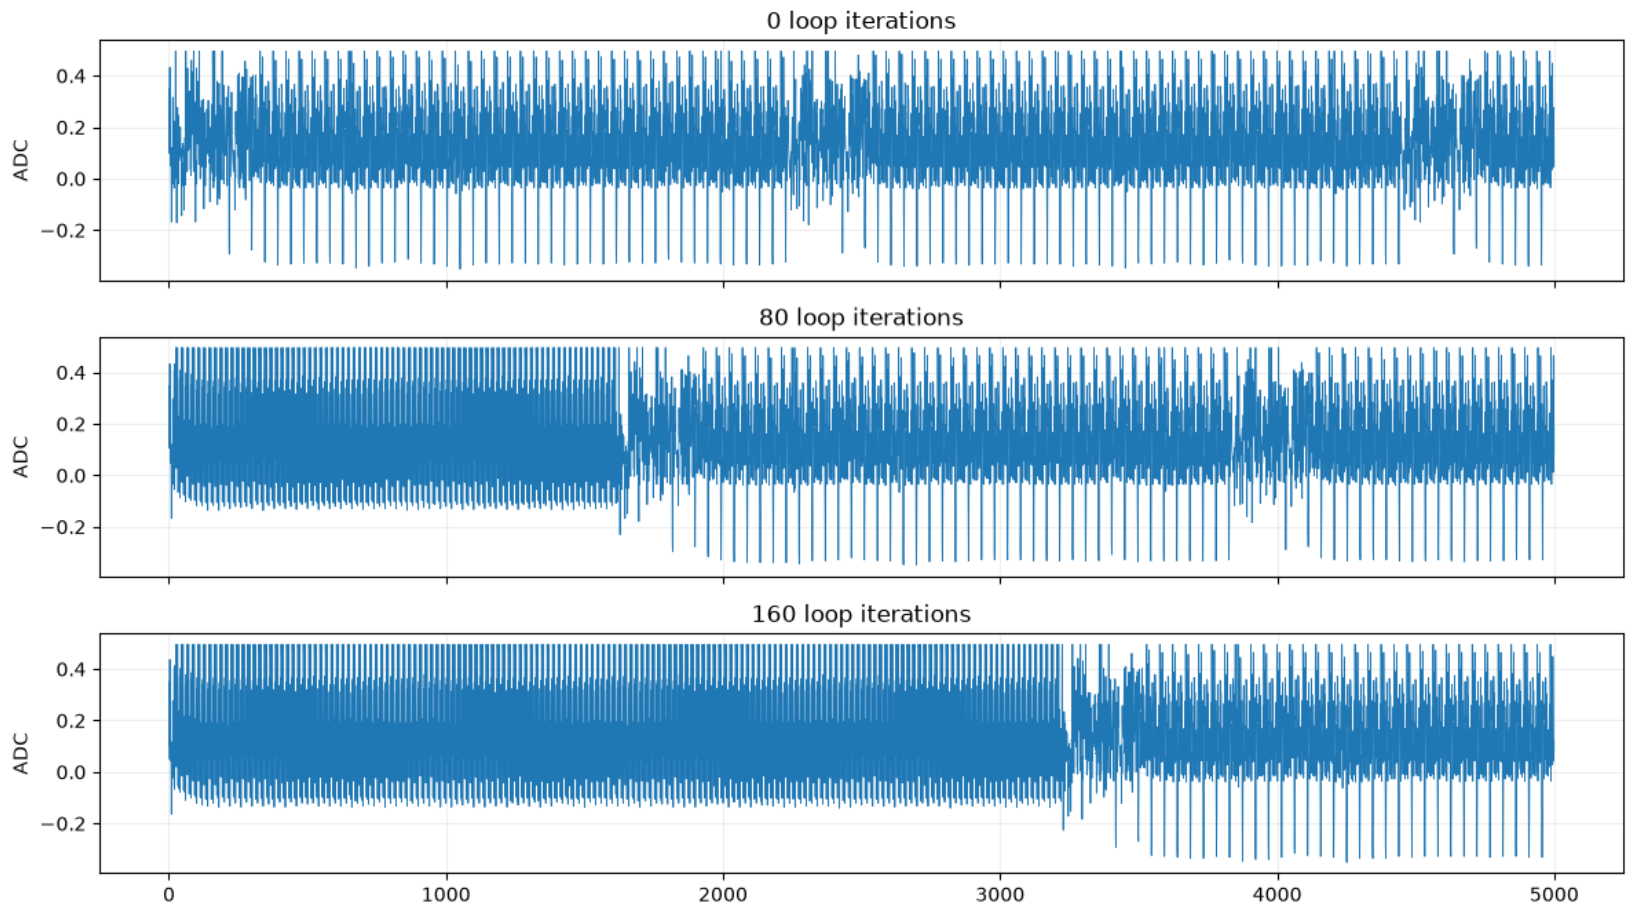
只是单纯的20次乘法对比无行为,电压变化不是很明显:
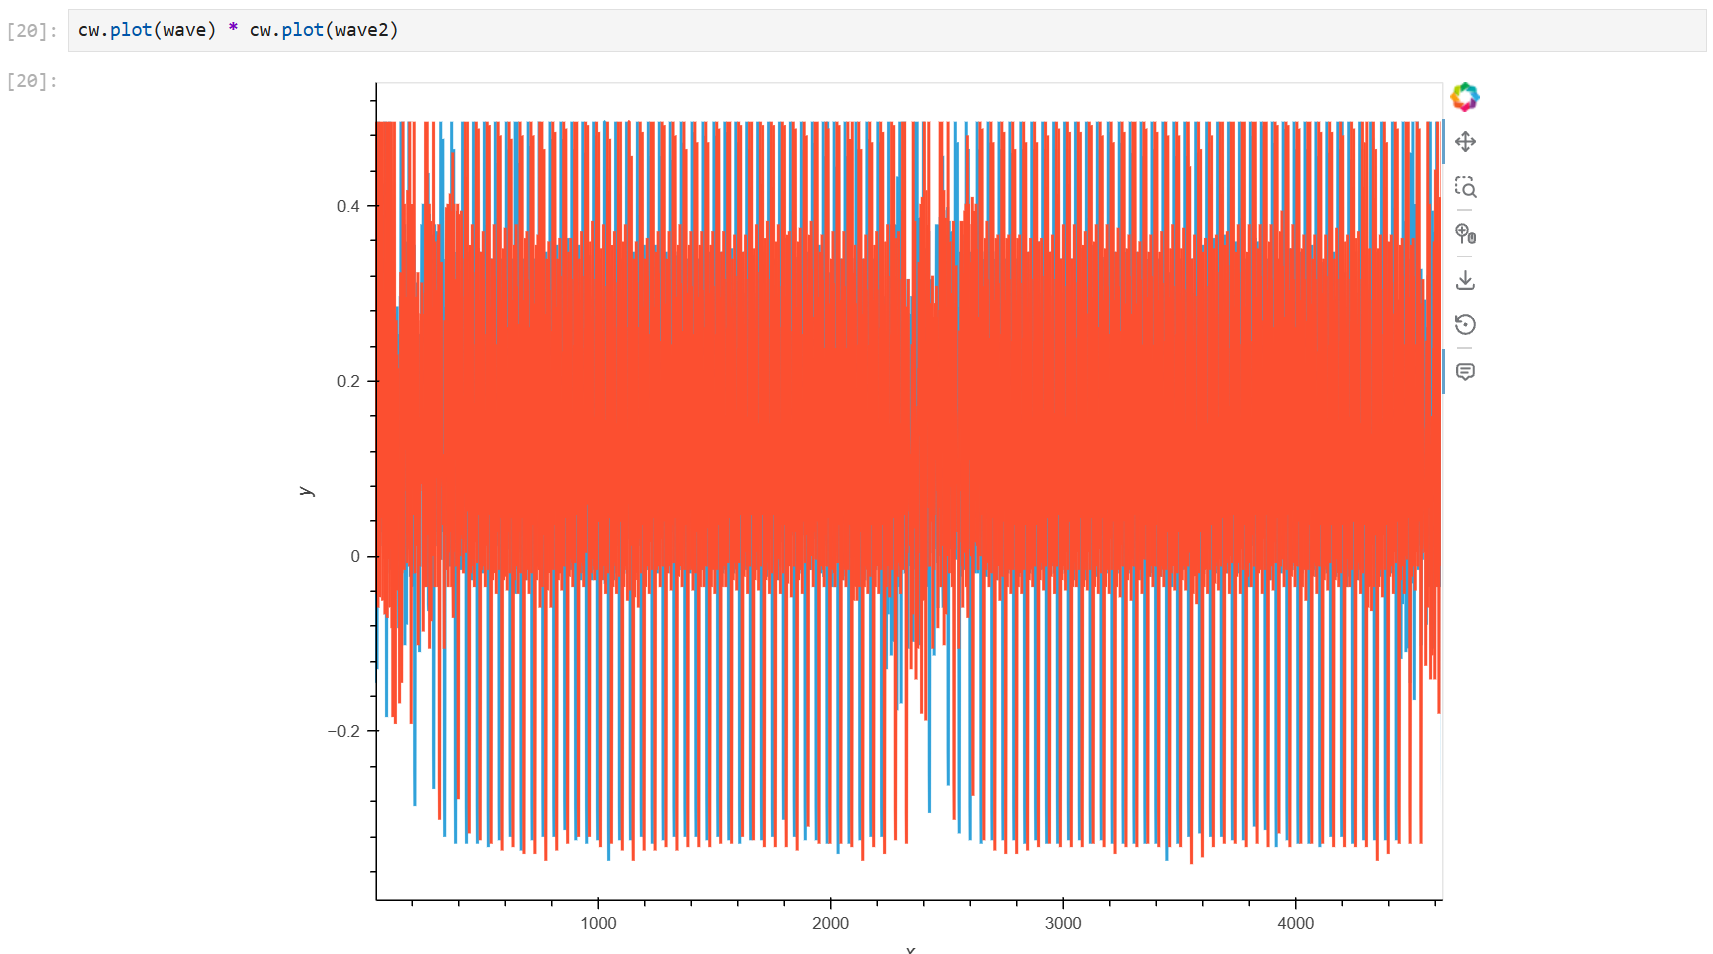
执行0、80、160次字节反转下的电压变化。
2.1B:利用功耗分析绕过密码
已知密码的第一个字母是h:
在前100个采样点即可看出差异
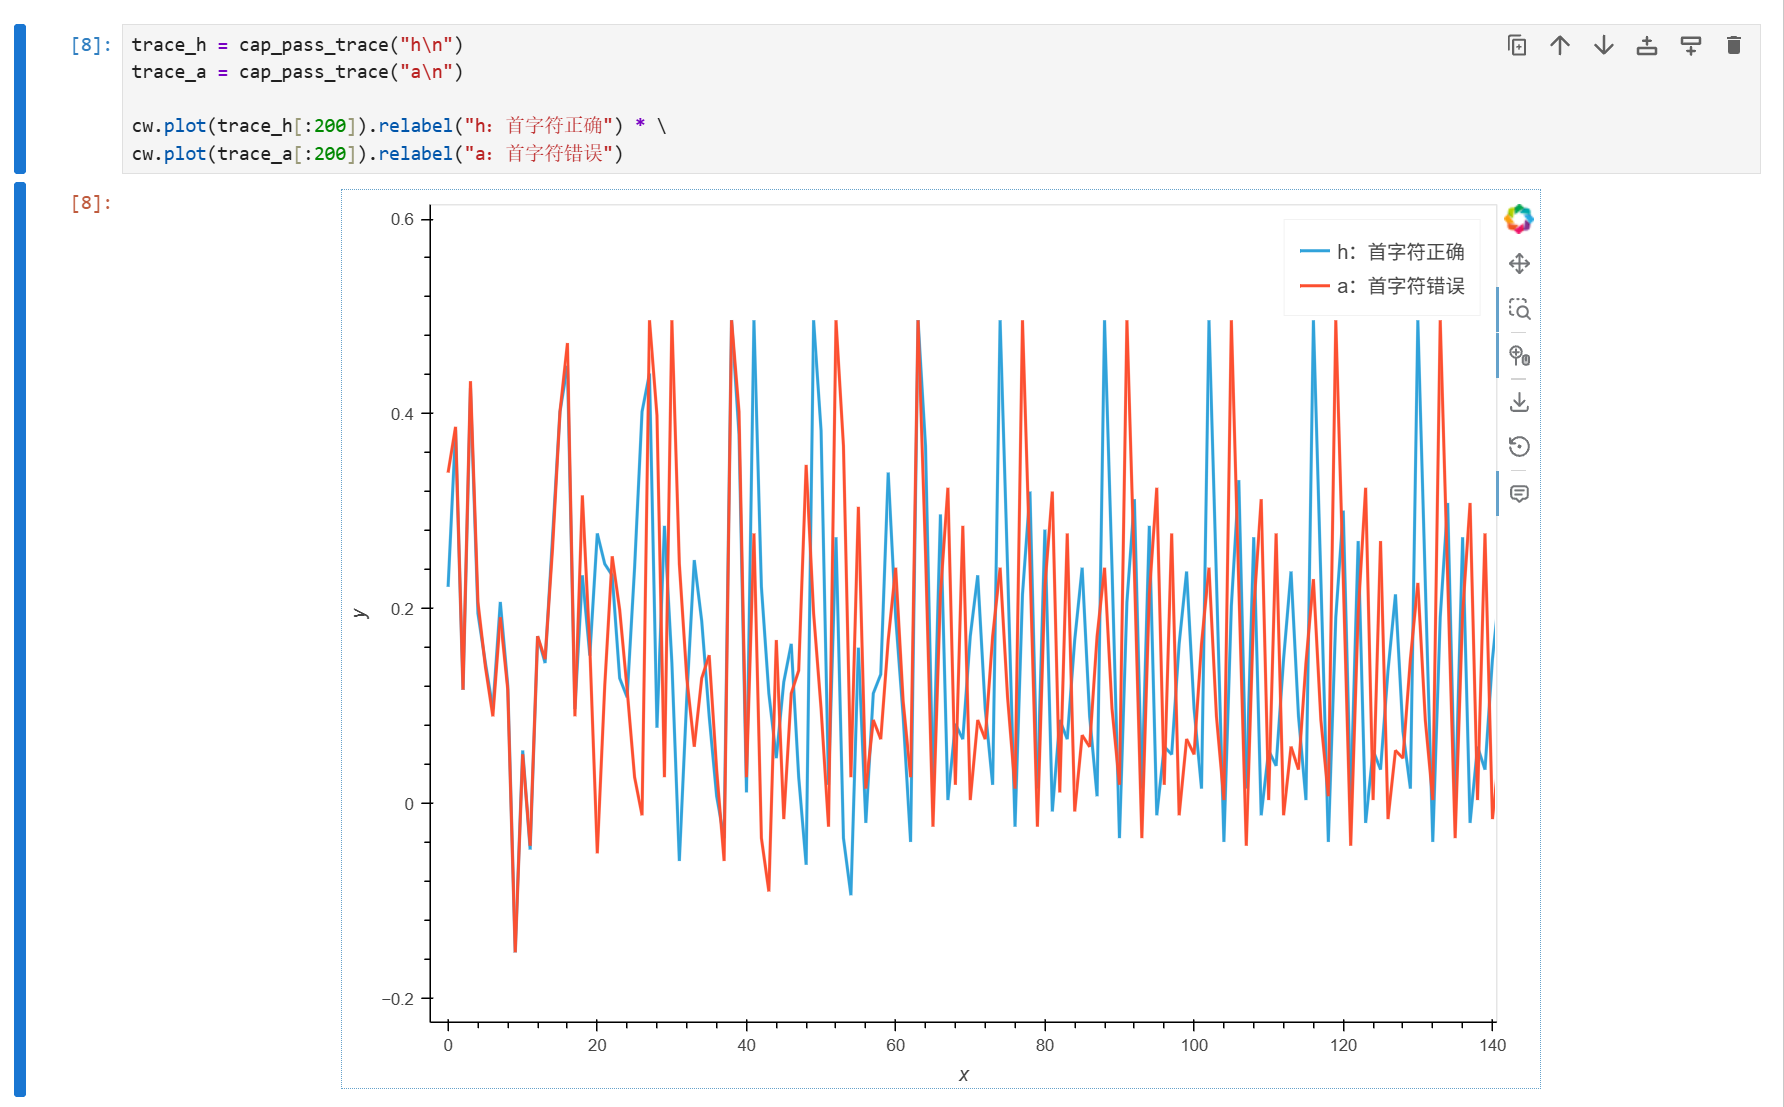
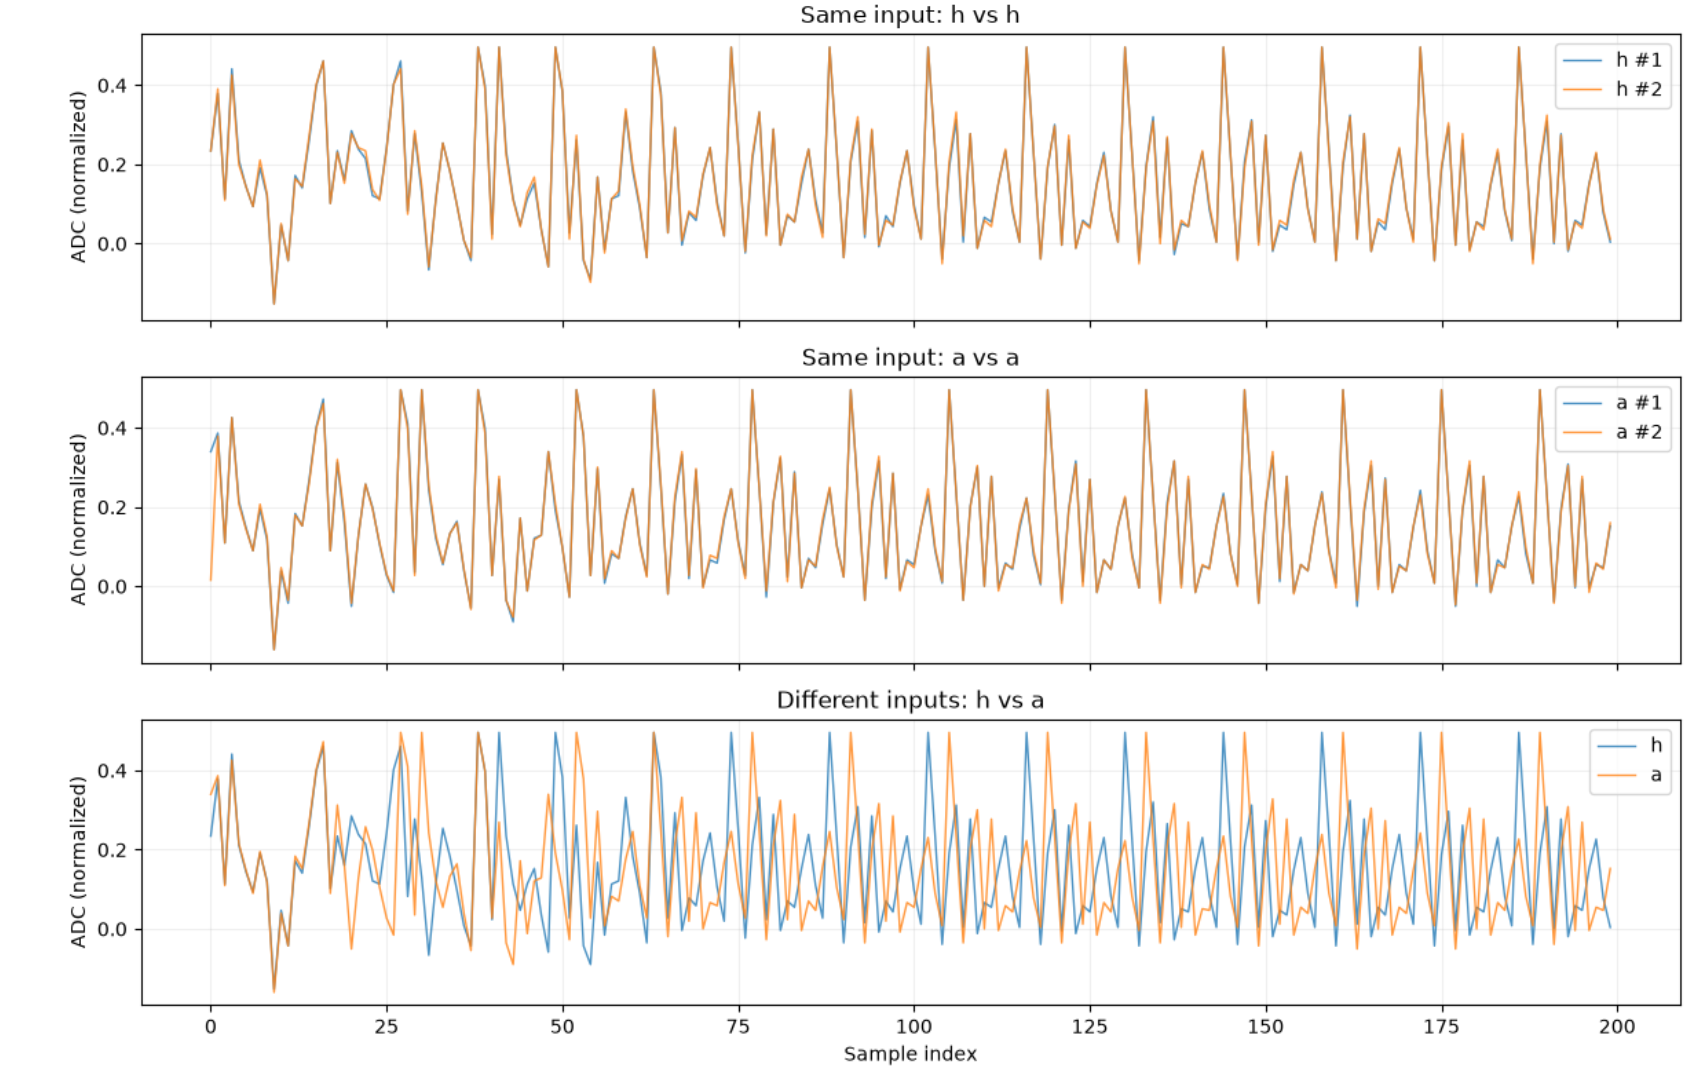
相同输入两次对比,不同输入对比:
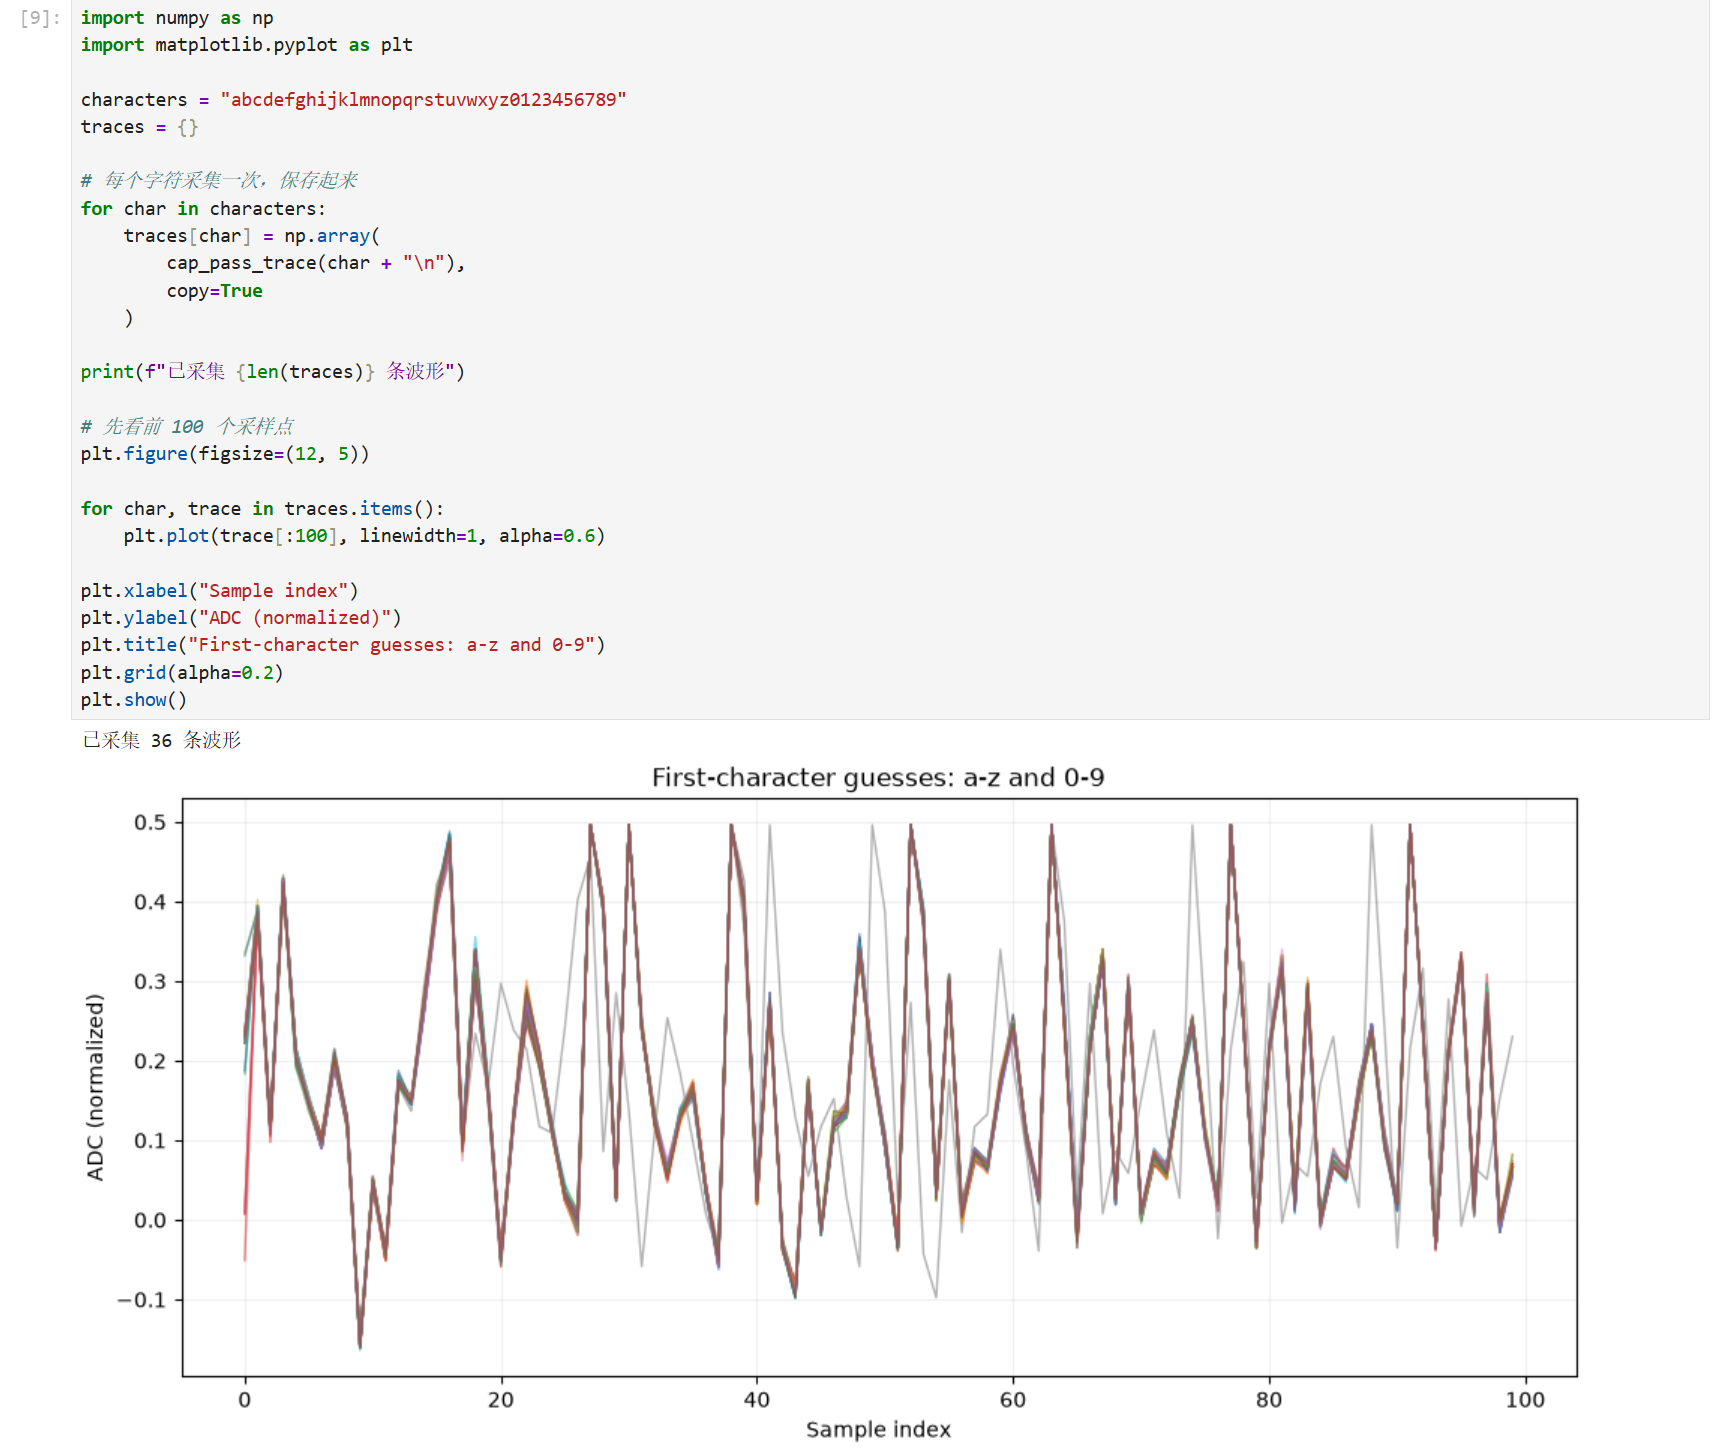
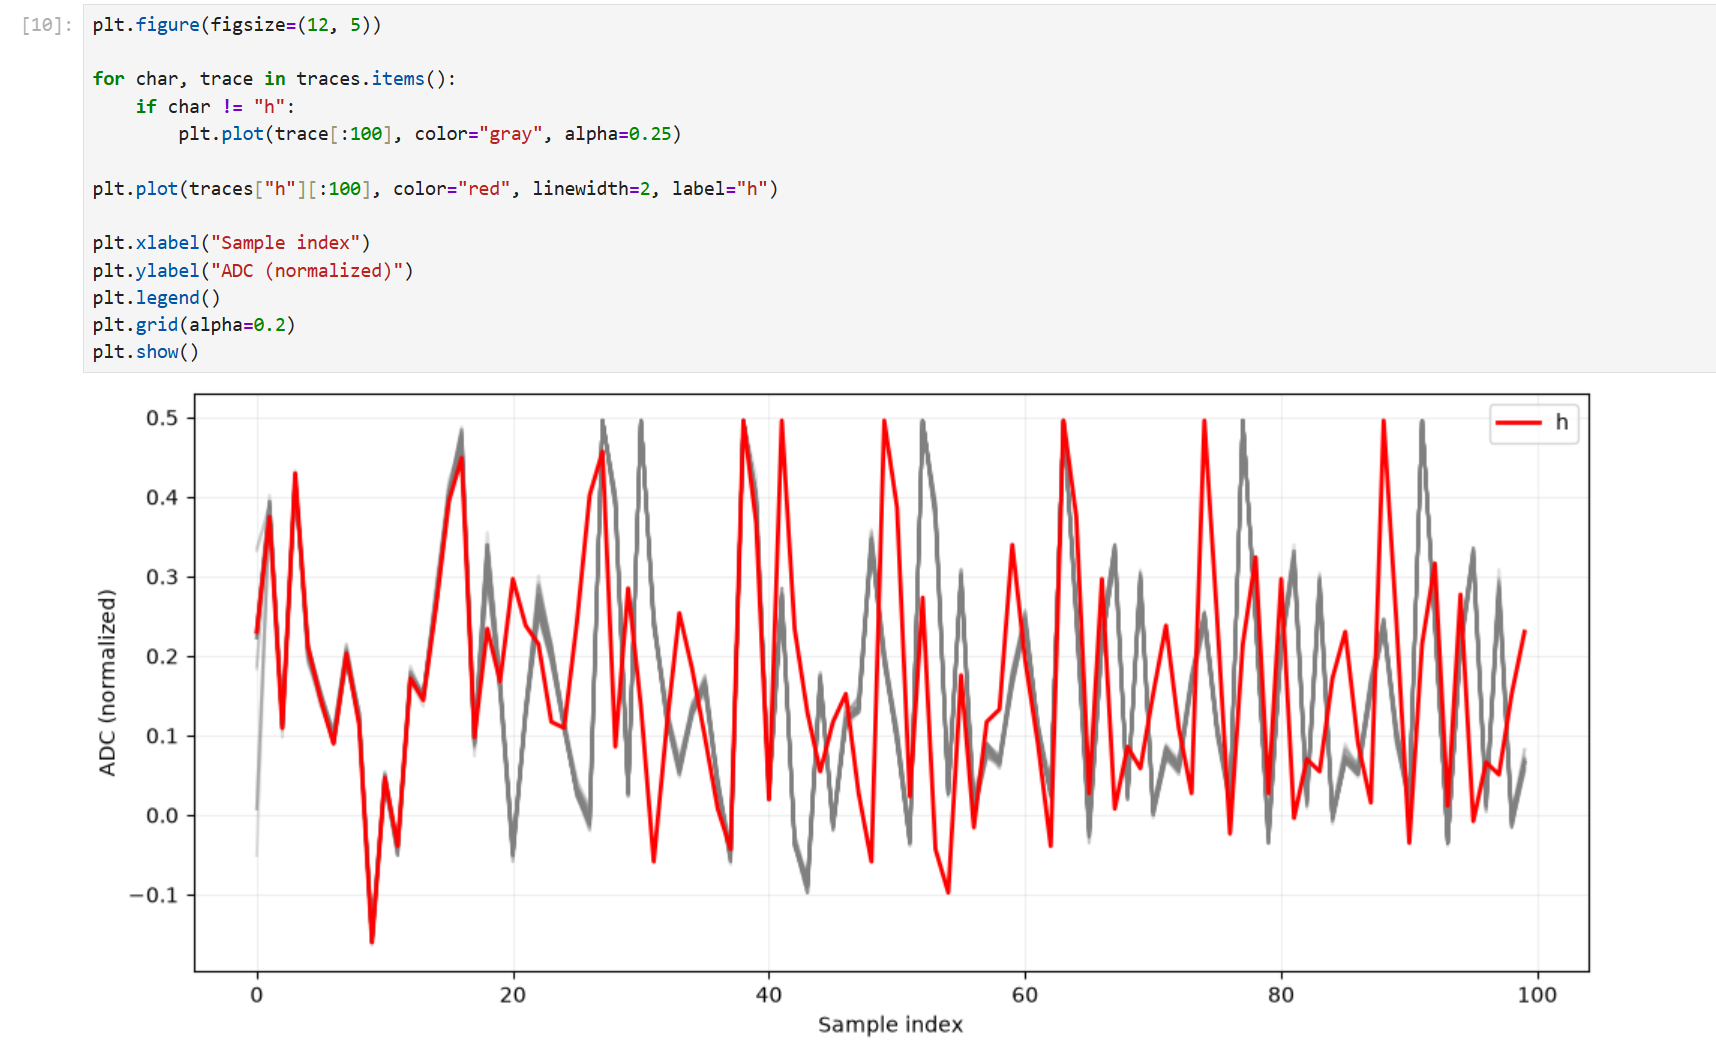
测试密码第一位:遍历abcdefghijklmnopqrstuvwxyz0123456789的波形,35条都重叠,只有一条除外:
单独高亮h:
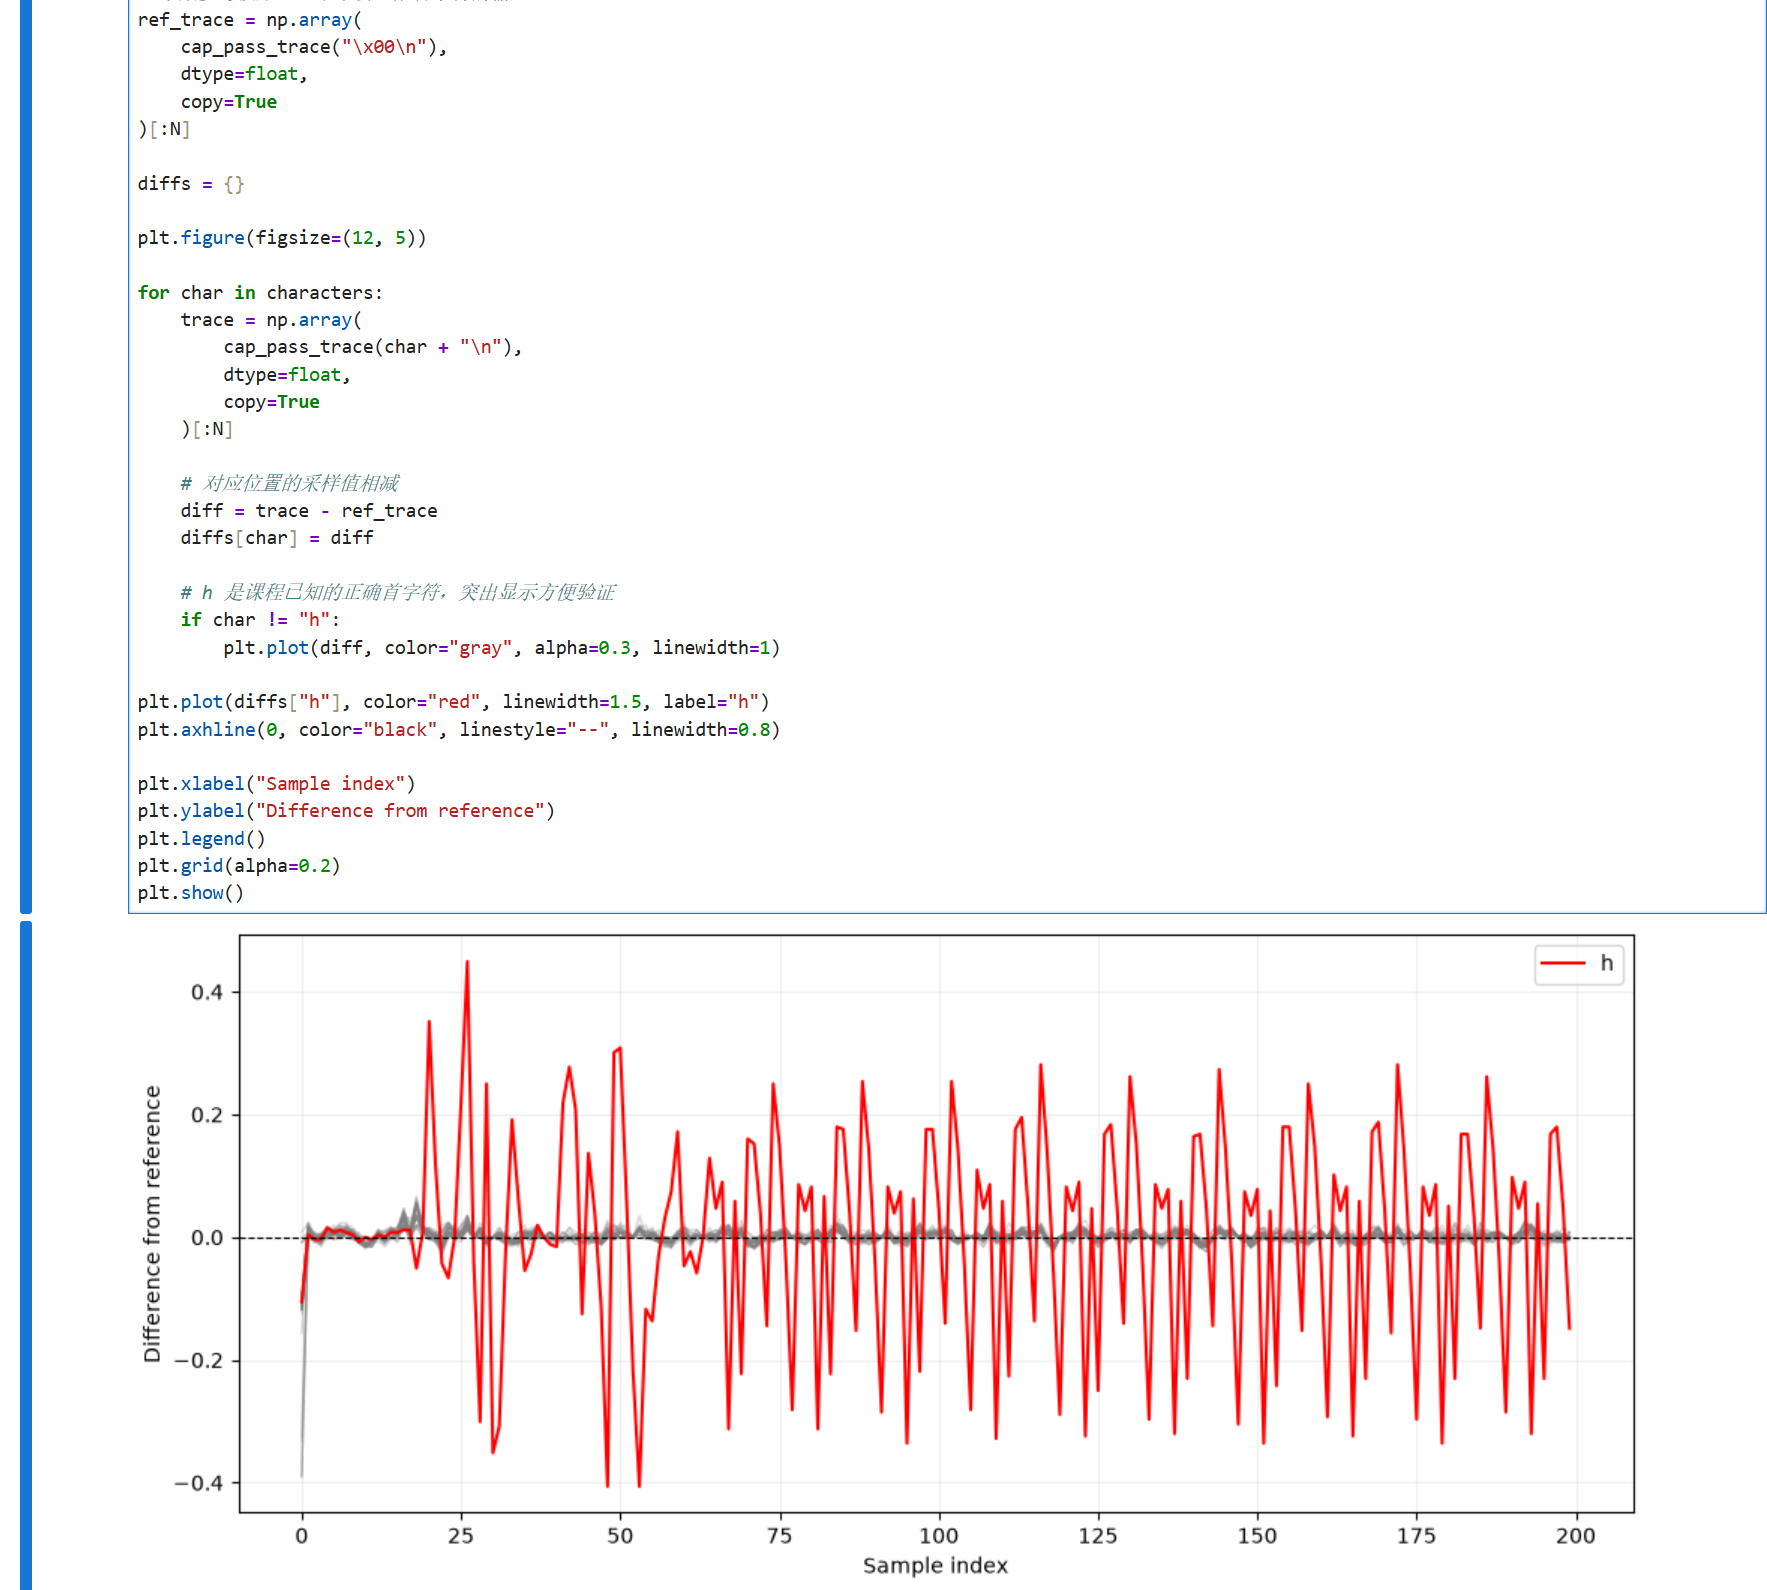
为了让差异更明显,让每条波形减去确定错误的波形(空字符\x00):
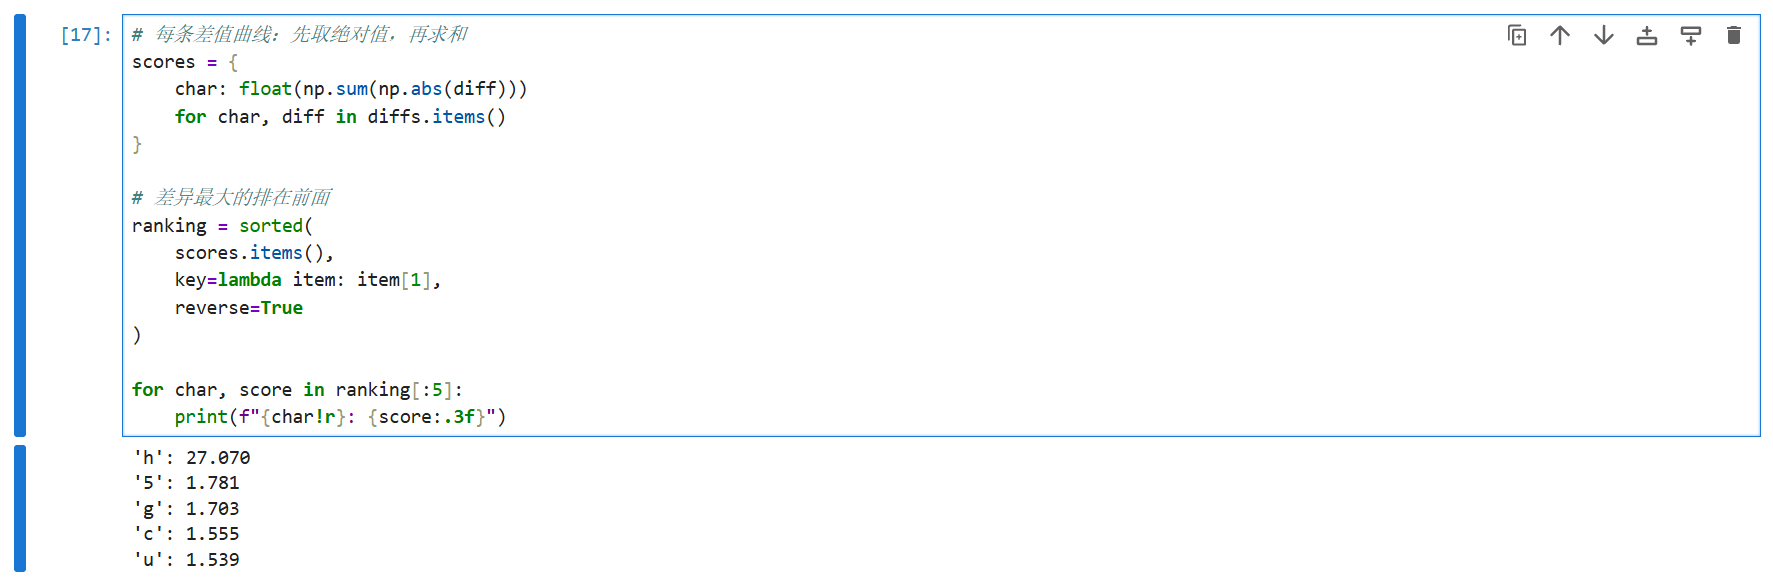
让程序自动处理这种差异:
每条差值曲线,先取绝对值,再求和
h明显高于其他:
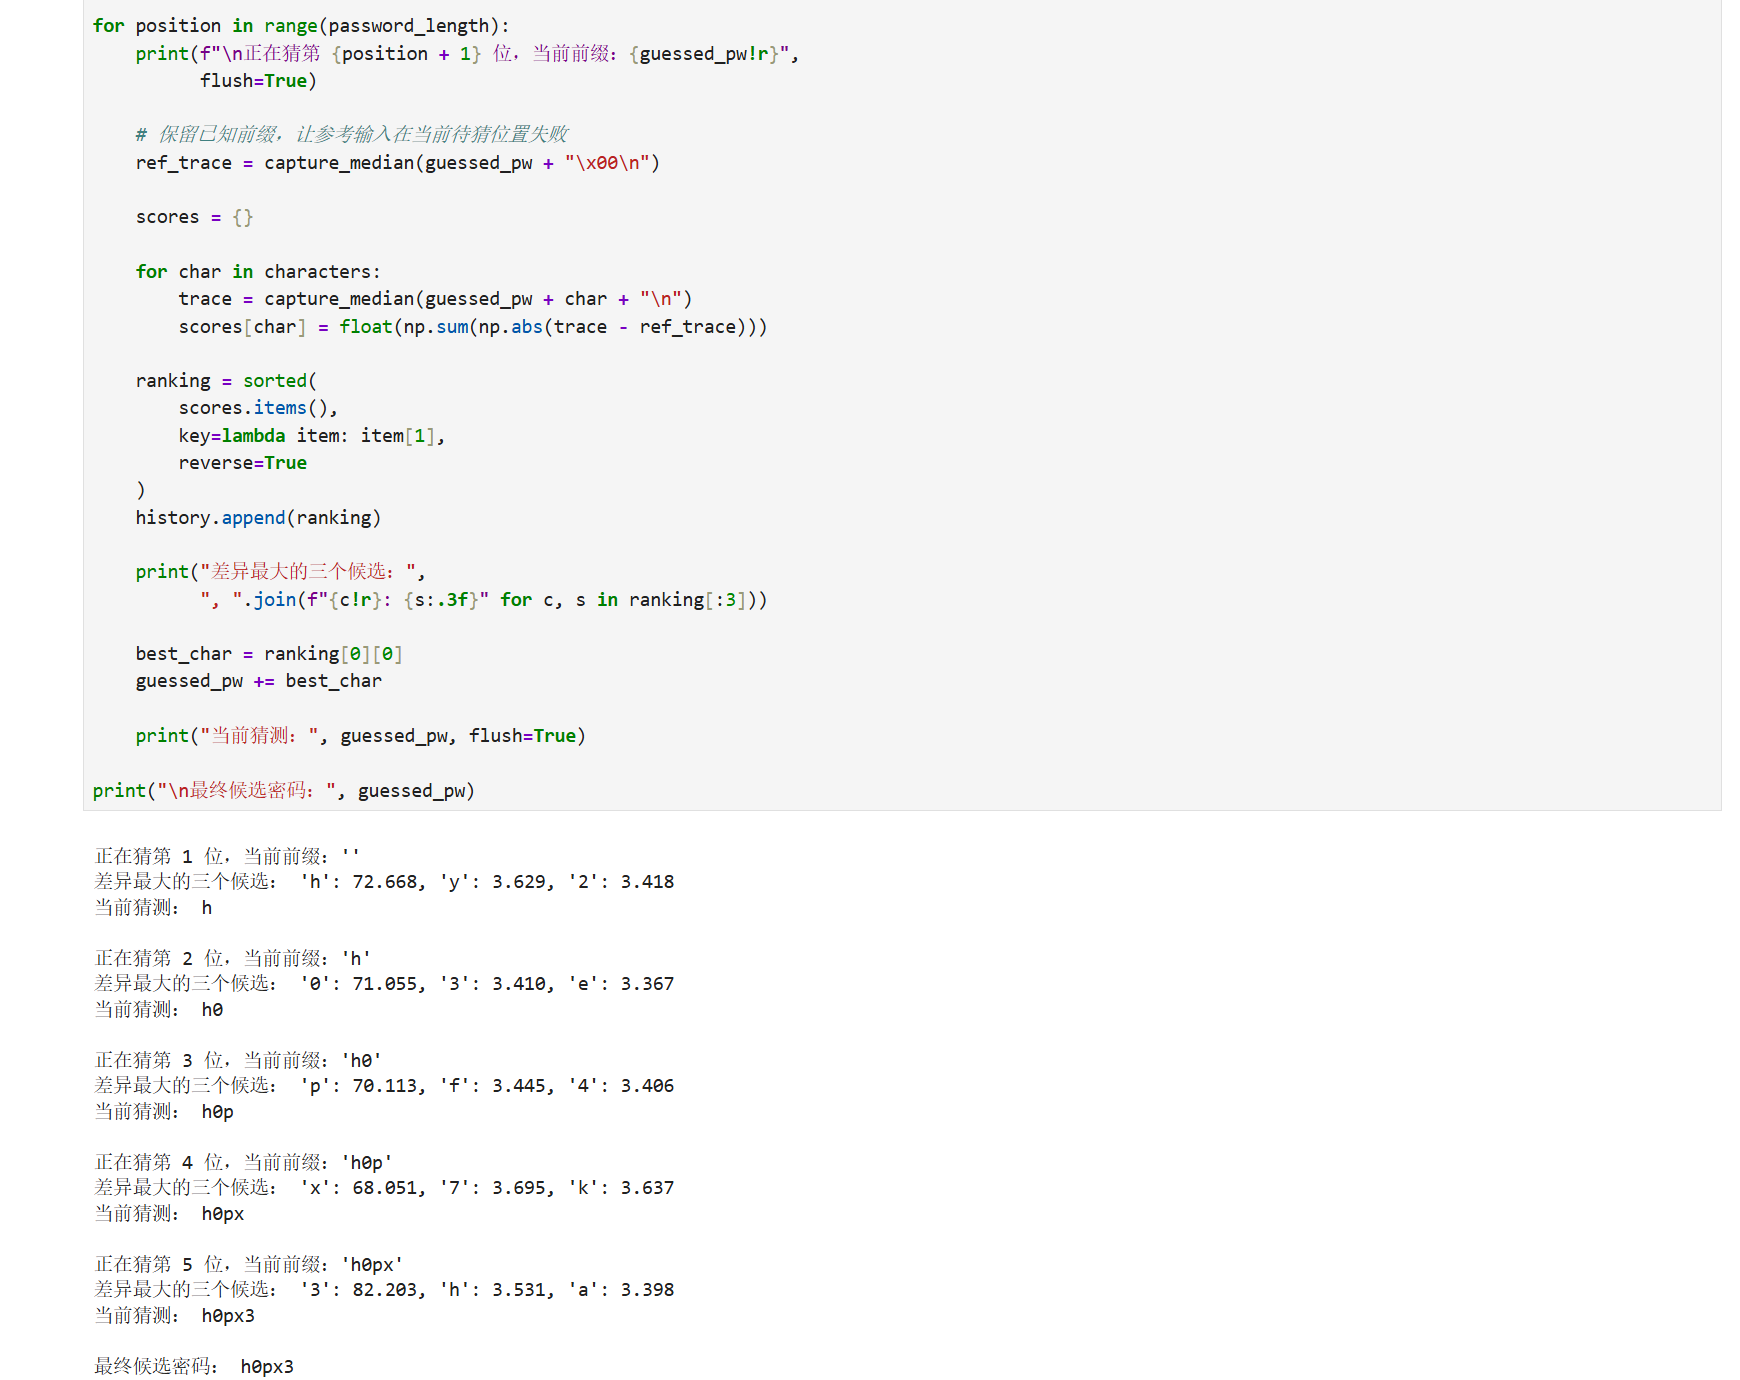
编写完整的攻击代码,取求和最高的为密码候选:
3.1:汉明重量的大幅变化
使用AEC加密第一字节为0x0或者0xF是否有功耗上的区别(其他字节随机)?
测量加密0和F共计100次的功耗,归一化后相减:
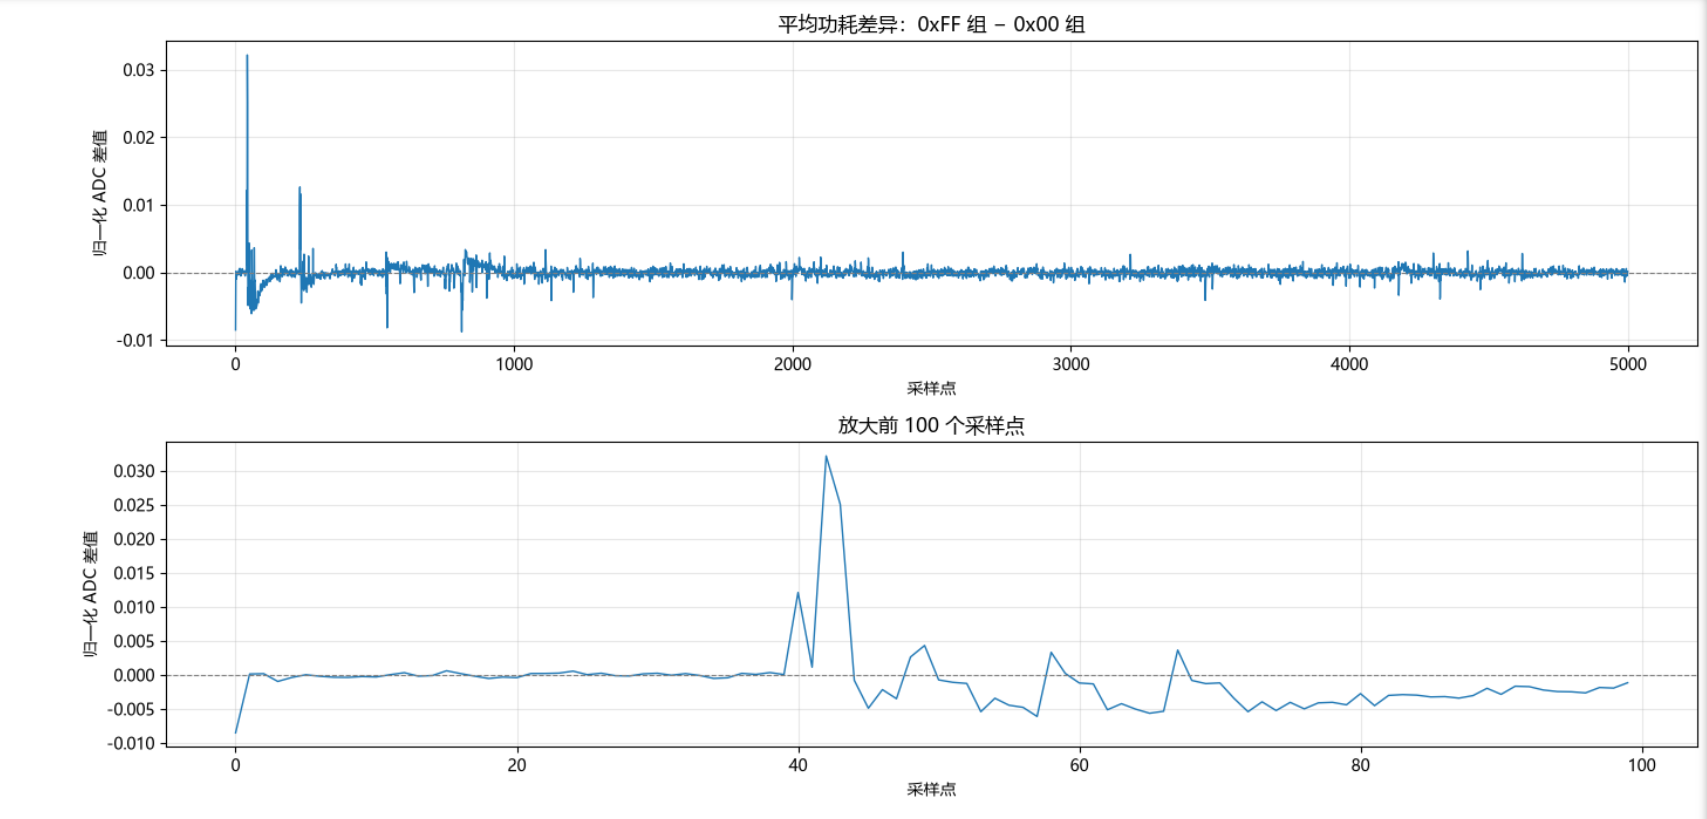
可见加密F的功耗在某一瞬间明显高于0。其他字节随机变化,分组求平均后,它们的影响会部分抵消,因此更容易研究第一字节的影响。
加密全0和全F的区别:
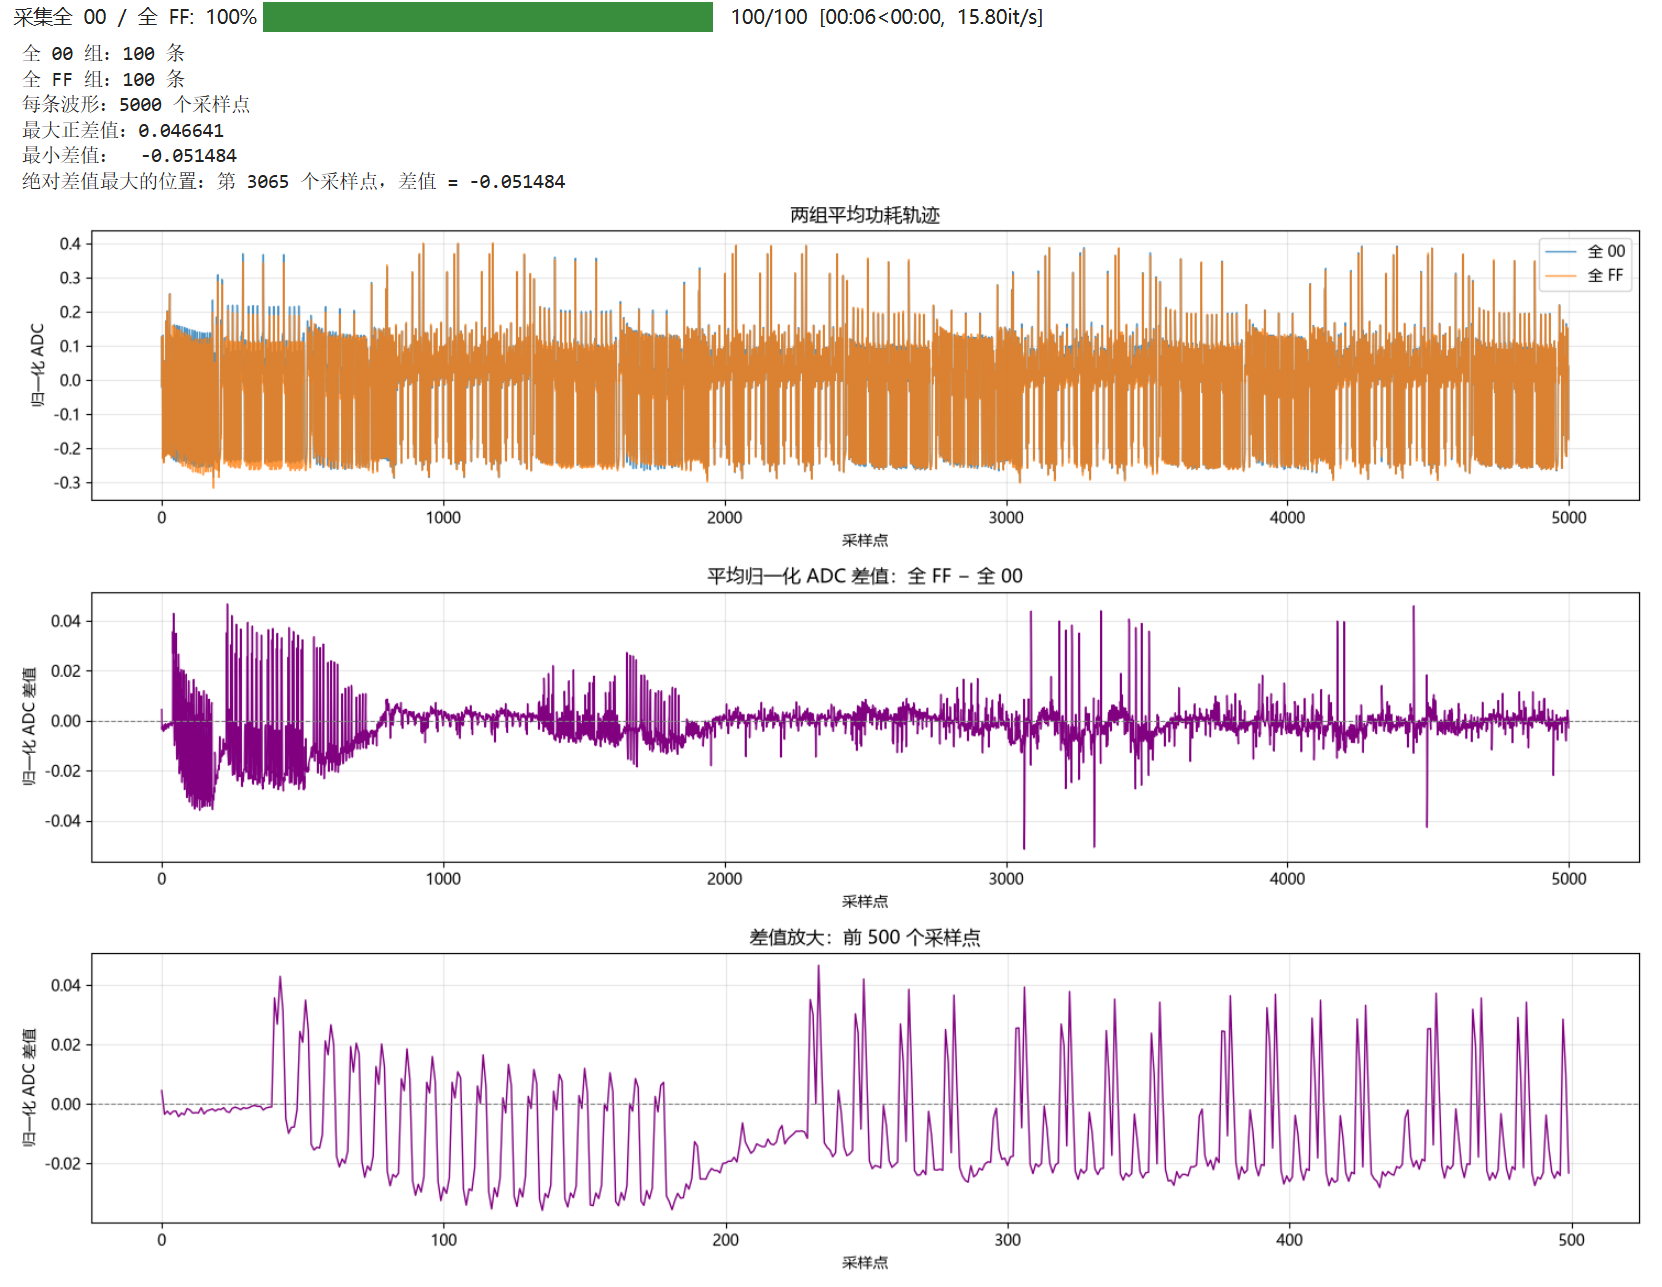
3.2 从单比特数据恢复 AES 密钥
假设我们可以通过某种方法拿到AES加密后的1bit的密钥结果。
那么我们是否可以利用这1bit的泄露恢复AES密钥?为了方便理解,这里只研究 一个输入字节、一个密钥字节,以及 AES 开始时的一小段运算。密钥字节只有 0~255,所以可以全部尝试。
1.先建立计算模型:知道算法,不知道密钥
我们知道设备内部执行的是:
输入字节 → 与密钥字节异或 → 查 S 盒 → 得到一个内部结果字节用代码表示:
def aes_internal(inputdata, key):
    return sbox(inputdata ^ key)
这个函数是我们的“预测工具”:只要给它一个输入和一个候选密钥,就能计算对应的内部结果。
2.模拟一个藏着真实密钥的设备
def aes_secret(inputdata):
    secret_key = 0xEF
    return aes_internal(inputdata, secret_key)
这里人为把真实密钥设为 0xEF。虽然你能看到源码,但实验约定:猜测程序不知道这个值,只能使用后面收集到的观察结果。
3.模拟泄漏:只给观察者看一位
假设内部结果是:
00011011观察器只暴露最低位:
???????1代码就是:
aes_secret(inputdata) & 1这里的 1 是代码从结果中提取出来的,不是 Nano 从硬件上读到的。
4.收集很多组“输入—泄漏结果”
随机生成 1000 个输入,每个输入都送进模拟设备:
input_data = [random.randint(0, 255) for _ in range(1000)]
leaked_data = [aes_secret(x) & 1 for x in input_data]
于是我们手里有:
| 第几次 | 已知的输入 | 观察到的泄漏 |
|---|---|---|
| 1 | 一个字节 | 0 或 1 |
| 2 | 一个字节 | 0 或 1 |
| … | … | … |
| 1000 | 一个字节 | 0 或 1 |
输入和泄漏记录是一一对应的。 之后猜密钥时,这批记录保持不变。
5.尝试一个候选密钥,预测同样的 1000 个结果
例如假设密钥是 0x23:
predicted = [
    aes_internal(x, 0x23) & 1
    for x in input_data
]
现在有两份答案:
真实观察:1 0 1 1 0 …
候选预测:1 1 0 1 0 …
          ✓ × × ✓ ✓
num_same() 就是数有多少个位置相同,作为这个候选密钥的得分。
6.遍历所有候选密钥,再按得分排序
依次尝试:
00、01、02、……、FE、FF在这个无噪声模拟里:
- 错误密钥:通常只能碰巧猜中一部分,大约在一半附近。
- 正确密钥:相同输入、相同算法、相同密钥,应该全部匹配。
np.argsort(scores)[::-1] 用来把候选密钥按得分从高到低排列。若设置没改,0xEF 应当得到 1000/1000。
7.如果连泄漏的是哪一位都不知道,就一起猜
用这个函数取出任意一位:
def get_bit(data, bit):
    return (data >> bit) & 1
然后尝试所有组合:
假设泄漏第 0 位 → 尝试 256 个密钥
假设泄漏第 1 位 → 尝试 256 个密钥
……
假设泄漏第 7 位 → 尝试 256 个密钥
总共 8 × 256 = 2048 种组合。每一种都与同一份 leaked_data 比较,寻找完全匹配的组合。
整个流程可以记成:
选择很多输入
      ↓
收集每个输入对应的泄漏信息
      ↓
提出一个密钥猜测
      ↓
用已知算法预测泄漏信息
      ↓
与实际记录比较、打分
      ↓
换下一个猜测
      ↓
按得分筛选候选密钥
它与后续真实功耗实验的连接是:
| 当前模拟实验 | 后续功耗实验 |
|---|---|
| 直接得到准确的 0 或 1 | 得到带噪声的功耗波形 |
| 统计预测 bit 与真实 bit 相同的次数 | 检查预测的内部数据与波形是否有统计关系 |
| 正确猜测可以全部匹配 | 正确猜测可能表现出更明显的差异或相关性 |
核心就是:密钥猜对时,你预测的内部行为,应该与实际观察到的信息相符。 单次泄漏只有一点信息,但许多次已知输入对应的泄漏,可以共同帮助排除错误猜测。