上一篇做的是我发链接、NAS 自己下。第二天接着往上做了一层:让它根据我看过什么来推荐,我回个编号就下。
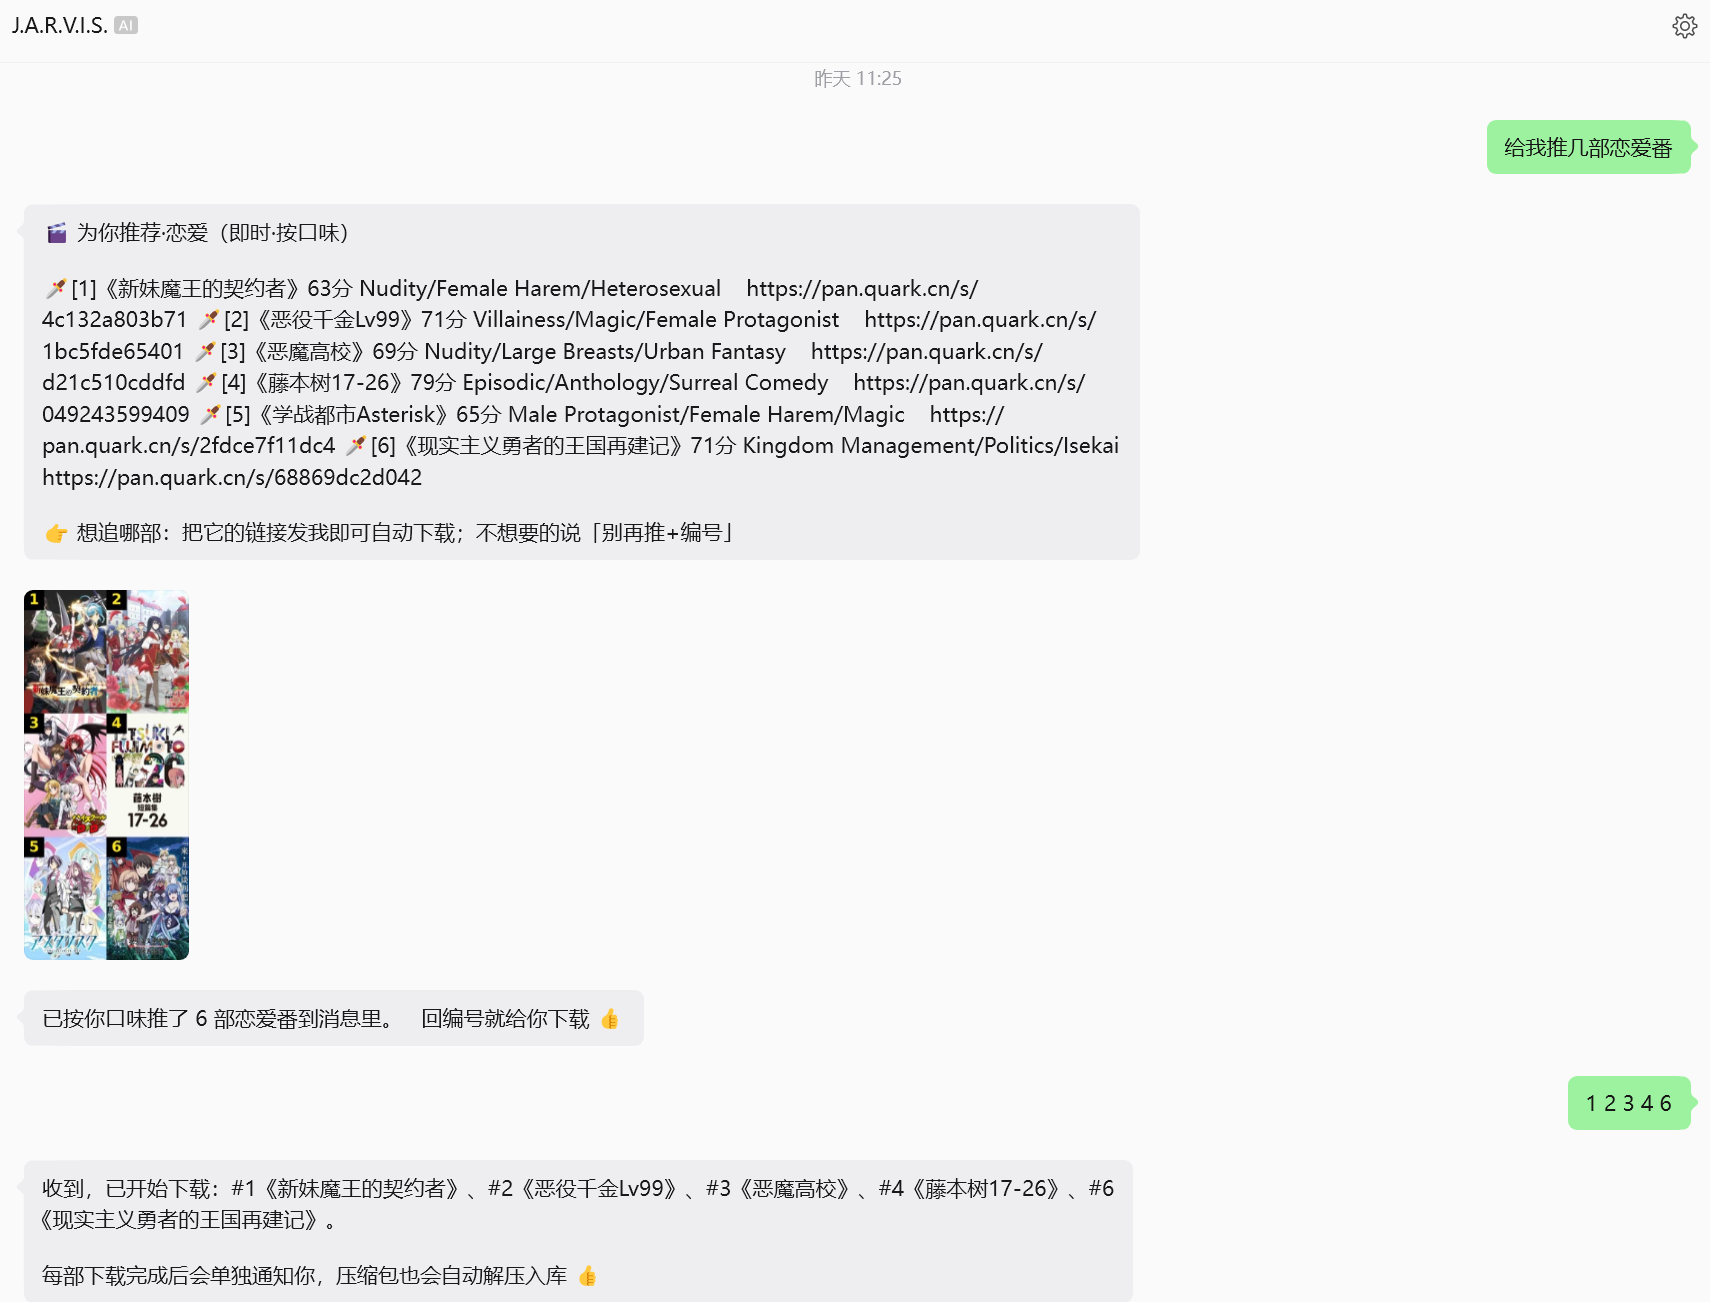
想看某一类的时候直接问它,回编号就开始下:
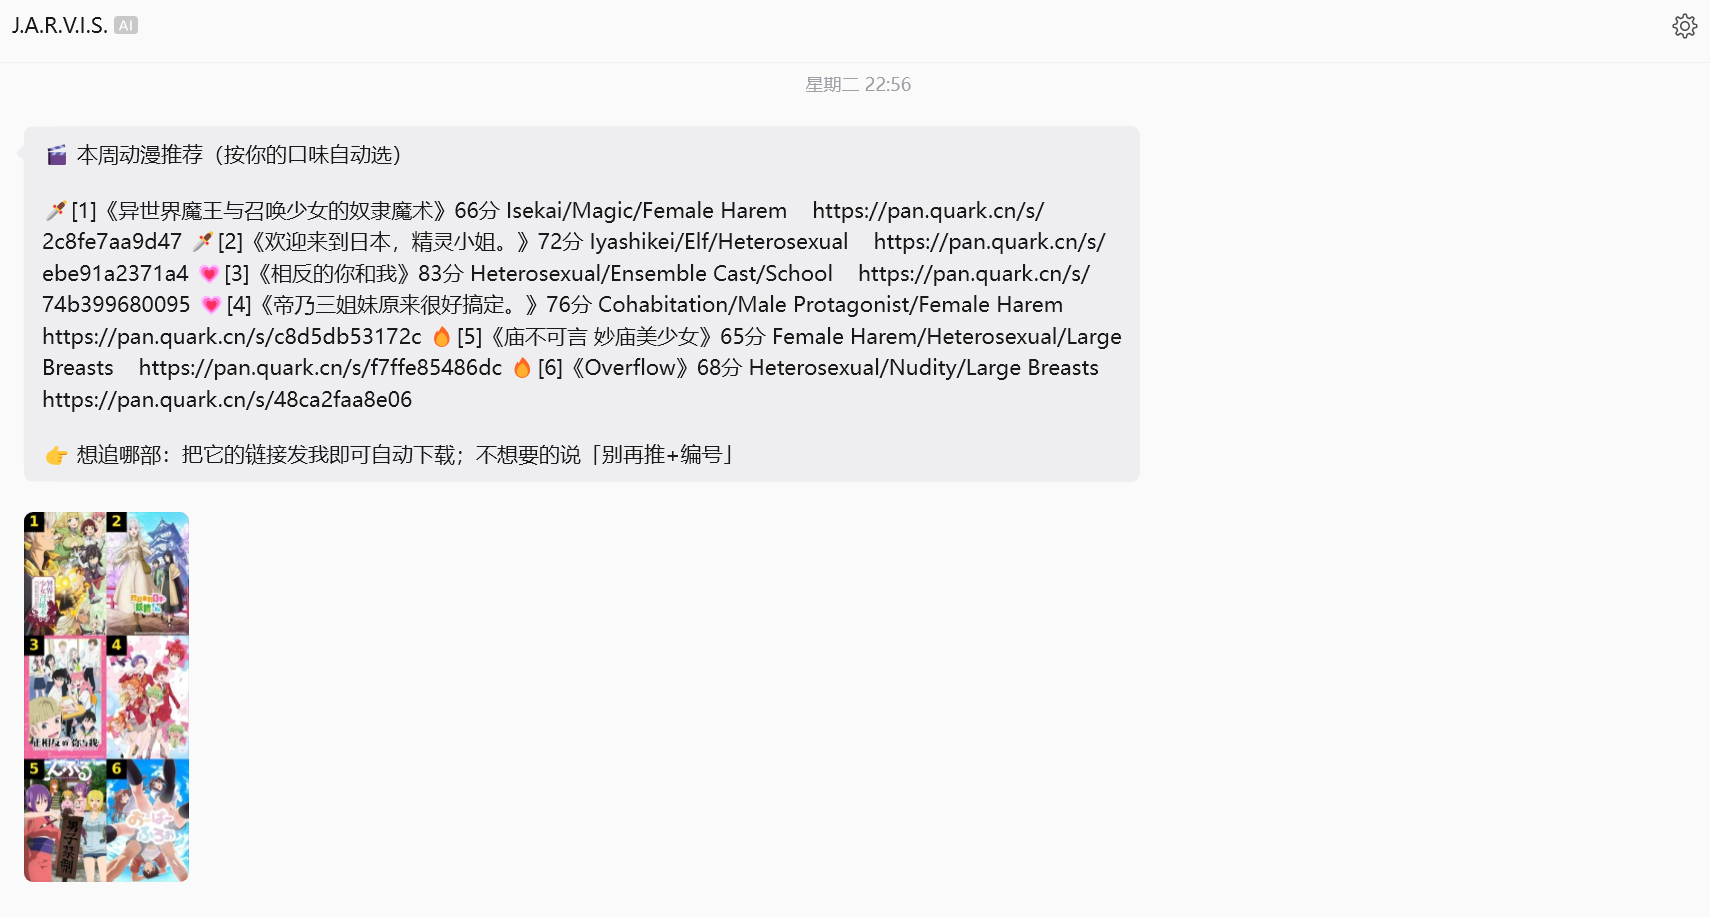
每周五它自己也会推一次:
现在能干什么
-
每周五晚上推 6 部:异世界、恋爱、福利各 2 部,带海报拼图和一句推荐理由。
-
某部番我全看完了,而且它确实已经完结,就马上再推 3 部类似的。
-
我回编号(比如
1 2 6),它在后台转存、下载、改名、配简体字幕、入库,每到一步推一条消息。 -
直接报片名也行;说“推荐点修仙的”就按类型推;说“给 XX 加字幕”就给已经在库里的番补外挂字幕。
-
同一部番有多个版本时自己挑;下到生肉就去找简体外挂字幕;分享里有剧场版就一起下到电影库。
-
完结的番下完就不再盯着,连载的追到完结自己停。
跑在飞牛 fnOS 上:几个 Docker 容器、几个 cron 脚本,加一个常驻的 agent(openclaw,管微信和 QQ 的收发,以及决定调哪个技能)。片子进 Jellyfin,我用 Infuse 看。
整体怎么分工
定了两条规矩。
第一,下不下我说了算。推荐它来做,但默认等我回编号才下。
第二,大模型只在必须用的地方用,全交给它跑太贵。拉 Jellyfin 数据、算向量、解析目录、粗筛、转存、下载、改名、推送,这些都是 cron 脚本干。agent 只管三件事:给粗筛出来的大约 50 个候选做最后判断并写一句理由,听懂我发的话,和我对话确认。
具体到组件:转存还是 quark-auto-save;下载还是上一篇那个每小时跑的 quark_sync.py;上面多了一个 quark_ctl.py,提供 probe / tmdb / addtask / sync / autodl 这些子命令给 agent 调;推荐本身是 anime_reco.py。媒体放在 mergerfs 合并出来的卷上(动漫、剧集、电影、动漫电影),新文件自动写到最空的那块盘。
口味画像
数据从 Jellyfin API 来。每部剧的 UserData 里有看没看完、还剩几集没看、最后一次播放时间。按投入程度给每部番一个权重:看完而且是近期看的 1.0,在追的 0.8,弃了的 −0.3。再把这部番在 AniList 上的标签按权重累加,归一化,得到一个向量。
我库里当时有 32 部样本,16 部看完、16 部在追。跑出来是差不多大的两堆:
-
异世界奇幻爽番:
Isekai / Magic / Super Power / Swordplay / Dungeon / Male Protagonist / Female Harem -
青春恋爱日常:
Romance / School / Slice of Life / Iyashikei / Kuudere / Cohabitation
我看了下,挺准。
有些偏好统计不出来,我直接口述了五条,写进打分里:
- 感情线最重要。为了男女主的感情线我能忍致郁剧情,但只有 Re:Zero 这一个例外,不能因此给我推致郁番。
- 不要降智。要爽,但不要无脑爽,用评分门槛卡掉低分的。
- 重口和致郁减分:
Tragedy / Gore / Horror / Survival / Boys' Love / Yuri / Male Harem。 - 福利不算重口:
Ecchi / Harem / Fanservice和爽向复仇是加分项。 - 偏好男主视角和异性恋:
Male Protagonist+1,Female Protagonist−0.8。
观看时长本来也想算进去。Jellyfin 的 Playback Reporting 插件能记时长,但我去看的时候里面只有 9 条记录,加起来一个小时出头,喂进去就是噪声。先让它攒着,以后再接。
货架
光知道我喜欢什么不够,还得有一份能下到的番的清单。用的是这位大佬整理并分享出来的目录,感谢:https://www.kdocs.cn/l/cnOBXUamMBJJ
它是个在线文档,.otl 格式。想直接爬下来,试了两条路都没走通:
-
带登录态的 cookie 调接口。文件元信息能读到(文件名、ID、大小、作者),但没有导出的口子:
/download返回unSupport (403),几个 export 接口全是 404。 -
逆向它的渲染协议。请求是前端的
preload-o.js动态拼出来的,私有协议,而且我对这份文档只有只读权限。成本太高,放弃。
最后用了最土的办法:在浏览器里把它另存为 .docx,然后解析 docx。docx 就是个 zip,里面是 XML。
这里有个坑。Word 把单元格里的超链接存成域代码 <w:instrText>HYPERLINK "..."</w:instrText>,不在可见文字里。只读可见文本(w:t)的话,番名有了,链接全丢。得把整个单元格的 XML 序列化出来,再用正则搜 HYPERLINK。
解析出来 2273 部,没有空名,抽查了一些,名字和链接对得上。以后目录更新就再另存一次、再跑一遍,diff 出新增的,只处理增量。
给每部番打标签
有了番名和链接,还得知道每部番是什么类型、有什么标签、口碑怎样。这一步前后跑了四轮,是整件事里最反复的。
第一轮用 TMDB。中文名直接搜 AniList 基本搜不到,连《葬送的芙莉莲》都没有。所以先拿中文名去 TMDB 匹配,命中 96%,顺便拿到日文原名、评分、类型和海报。
第二轮拿日文原名去 AniList 查细标签,命中 55% 左右。
这两轮踩的坑:
-
请求头的 UA 必须是浏览器的。带
my-script/1.0这种脚本标识会被 Cloudflare 拦掉,返回 404。 -
AniList 的 GraphQL 地址末尾要带斜杠。
-
AniList 批量查询里只要有一条查不到,整个响应就是 HTTP 404,但 body 里其他条目的数据是有的。得把 404 接住照样读 body,不然整批白查。
-
TMDB 的 API 在国内直连不通,请求要从 NAS 上发(NAS 挂了代理)。AniList 反而在我电脑上就能直连。所以两个分开跑。
第三轮是我提的。当时还剩 873 部没标签,我觉得这些番不可能都没被收录,更像是搜的姿势不对,换日文名、英文名应该能查到。于是按原名、清洗过的原名(去掉副标题、括号、季数)、中文名的顺序依次重查;不是按原名命中的,再加一个 ±3 年的年份校验防止配错。每条间隔 1.3 秒,遇到 429 等 60 秒,每 40 条存一次盘。结果命中 681,剩 192。
第四轮,剩下这 192 部靠规则搞不定:2025 年的新番还没收录,续作名字复杂(“第四季 丧失篇”),剧场版分章,一部番好几个译名(蓝箱 / 青春之箱 / 青之箱),国产动画原名就是中文。这批交给大模型:开 6 个 agent 并行,每个 32 部,自己去 MAL、AniList、Bangumi、维基、萌娘查,按固定格式输出类型、标签和一个 0–100 的评分,最后合并写回。192 部全部配上,其中 177 部它自己标了高置信。抽查了几部:《幼女战记》是 Military / Isekai 81 分,《电锯人》是 Gore / Tragedy 83 分,对得上。
合并的时候差点漏一条。agent 把番名写回来时,把“亚刻奧特曼”的“奧”写成了“奥”,按名字就匹配不上了。所以写库之前先拿结果里的名字和原清单对了一遍,对不上的只有这一条,改掉再写。
到这里 2273 部全部有标签。
推荐
分两步。先用口味向量给所有番打分,粗筛到 50 部左右;再过质量门槛,分异世界、恋爱、福利三类各取前几名。打分大致是这样:
def score(show, taste):
    s = 0
    for tag in show.al_tags:
        s += taste.weight.get(tag, 0)              # 口味标签加权
    s += GENRE_BONUS(show.al_genres)               # 类型偏好(异世界/恋爱/福利)
    if show.al_score: s += (show.al_score - 70)*0.1  # 口碑微调
    if show.year < 2010: s -= 3                    # 老番降权
    elif show.year < 2015: s -= 1
    if is_sequel_without_prequel(show): return SKIP  # 没看前作的续集不推
    return s
状态记在一个 json 里,规则是我定的:推过的 30 天内不重复推;我说“别再推 X”就进黑名单,永远不推;NAS 里已经有的,不管看没看都不推。
触发有两种。一种是每周五晚上 8 点定时推。另一种是每半小时查一次 Jellyfin,发现哪部番刚从没看完变成全看完,并且 TMDB 上的状态是 Ended 或 Canceled,就推 3 部相似的。连载番追平最新一集不算看完。
推送是一段文字加一张图。6 张海报用 PIL 拼成两列的长图,每张叠一个黄色编号,和文字里的序号对应。不一张张发是因为微信连发多图会被限流,QQ 偶尔会丢图。海报要先在 NAS 上用 curl 从 TMDB 下到本地再发,直接把远程 URL 给发送脚本会报 fetch failed。
两个小坑。Pillow 装在 agent 用户的 ~/.local 下面,cron 那一行要带上 HOME=...,不然 import 不到。微信那边发送偶尔返回 iLink ret=-2,意思是会话失效了,得我主动给机器人发条消息才能恢复,代码改不了。所以微信和 QQ 各自 try,一个挂了不影响另一个。
回编号之后
第一次真用是 6 月 17 日,我在 QQ 上回了“1 2 6”。回完一直没动静,过了零点才收到一条入库通知。
查下来是这样:当时的做法是 agent 在同一轮对话里把几部番依次下完再回我。结果这一轮在 23:58 因为模型空闲超时挂了,下载是靠留在后台的进程在 00:11 跑完的,中间什么回执都没有。第 6 部压根没下,它在分享里是个压缩包,后面说。
于是改成异步。agent 收到编号后马上回一句“收到,已开始下载”,用 setsid 把 autodl 丢到后台,这一轮对话就结束。之后转存完、字幕配好、剧场版入库、全部完成,每一步由脚本自己推消息。
夸克接口的三个点
转存和取直链都在 quark-auto-save 的容器里做,因为账号 cookie 在容器里。
- 要转存分享里的某个子文件夹,URL 得写成
<分享链接>#/list/share/<文件夹 fid>-x。 save_file用的share_fid_token必须和取它时的 stoken 是同一次会话的。分两个脚本、两次调用去拿,就报41020 token 校验异常。download接口返回两样东西:响应本身,和一个针对这次下载的 cookie。给 aria2c 的Cookie头得是账号 cookie 加上它,少了后半截就是 403。
第三条就是上一篇文末那次全线 403。
漏季
一部四季的番,我一次把四季都提交转存,结果第四季没转上,账号里那个文件夹是空的,下载那一步自然什么都没下。
后来改成一季一季来:转存,查账号里这一季确实有文件,没有就重试,最多 10 次,每次隔 20 秒。10 次都不行就推一条失败消息,不往下跑。
两边同时下
autodl 和每小时那个 cron 都会触发下载。一开始 autodl 没加锁,两边撞在同一个文件上,aria2c 降成了单线程,卡了两个小时,在重下已经下好的集。给两边加上同一把 flock 就好了。但负责串行调度的脚本外面不能再套一层同样的锁,否则自己等自己,死锁。
清理那次卡住的进程时还把自己坑了。pkill -f quark_sync.py 会匹配到 SSH 那头正在执行这条命令的 shell,因为命令行里就带着这串字,一敲连接就断。之后杀进程都用 PID。
改名偶尔失败
TMDB 或者夸克那边 SSL 断一下,集名就没补上,文件名只剩 S01E05。加了失败重试,最多 3 次,间隔 5 秒。
选哪个版本
一个分享里经常同时有好几个字幕组、好几种画质。怎么选是我定的:先看清晰度,10bit、超分、4K 这些优先;清晰度一样选文件大的;字幕只有内嵌繁体或者不是中文、又换不了的,直接跳过。
照这个写完很快翻了一次车。《现实主义勇者的王国再建记》下回来只有 14–26 集,那个分享把一部番拆成了两个文件夹,脚本挑中了只有后半的那个。于是在最前面加了一条:先看谁的集数全。
def select_version(folders):
    ok = [f for f in folders if sub_ok(f) > 0]   # 滤掉只内嵌繁体/非中文且不可换的
    pool = ok or folders                         # 全是差字幕才退而求其次
    return max(pool, key=lambda f: (
        len(f.episodes),     # ① 覆盖完整(底线): 防选到只有后半季的分卷
        quality_score(f),    # ② 清晰: 关键词 2160/4K > 1080 > 720, +10bit/超分/HEVC
        f.total_size,        # ③ 同清晰选大文件: 1G 系列优先于 512M 系列
sub_ok(f))) # ④ 字幕可用性清晰度是从文件夹名和文件名里抓关键词判断的:2160/4K、10bit/Hi10p、HEVC/x265、FLAC。
压缩包和密码
有些番(主要是里番)在分享里不是视频,而是一个后缀为 .exe 的压缩包,还带解压密码。我当时猜是把压缩包改了个后缀,实际是 Bandizip 的自解压壳。不过无所谓,7z 是按文件头认格式的,直接 7z x 就能解,用不着 wine。
最开始探测分享时只认含视频的文件夹,这种只有压缩包的被当成空的,不下也不报错。前面那次“1 2 6”里的第 6 部就是这么没的。
密码放哪没有定数:可能写在一个空文件夹的名字里,可能在同目录的 txt 里,也可能就是上传者的链接或者番名。所以把这些都收集起来当候选,一个个试,哪个成功就记下来,下次优先用。
有一个密码很坑。文件夹名上写的是 ruach@66,怎么试都是密码错误。真密码是 ruach,@66 是多出来的。于是又加了一条:形如 x@y 的,把 @ 前面那段也当候选。
还有一种分享是混着放的,前几集是 mkv,后几集在压缩包里,一开始只下到了前几集。现在视频、压缩包和密码文件一起转存,按集号去重,本地已经有的集不再解。
解压出来的东西里会混着 NCED / NCOP / Menu / SP / Secret Video 这类非正片,按集号改名之前要先滤掉。
字幕和剧场版
《游戏人生》下完,我发现两个问题:没字幕,剧场版也没下。
脚本选的是 VCB-Studio 的 1080p 版本,画质最好,但它是生肉。简体字幕放在旁边一个叫“外挂字幕”的子文件夹里,剧场版《游戏人生 ZERO》在同一个分享的另一个子文件夹里,两个都没被碰。
我先手动把这一部补齐,然后把这两步做进了 autodl,放在主下载之后。都包了 try,失败就跳过,不影响正片。
字幕有个硬规矩:Jellyfin 只认和视频完全同名的外挂字幕,包括改名时加上去的集名,只多一个语言标记和后缀。所以字幕必须等视频改完名再处理:按集号找到库里那个视频,用它的完整文件名加 .zh.ass。
剧场版用正则认,只认“剧场版 / 劇場版 / the movie / gekijou”这种明确的字样。不能匹配单独的 ZERO 或 movie,不然 Re:Zero 的 TV 版会被当成剧场版扔进电影库。
后面陆续又修了几个:
-
重复字幕。《在地下城寻求邂逅是否搞错了什么》第一季下载时就自带字幕,文件名是不带语言标记的
.ass。补字幕时只检查了.zh.ass存不存在,于是整季又加了一套,每集两条字幕。现在只要有任何同名字幕就跳过。原包自带的字幕时间轴肯定对得上,优先留它。 -
Season 2 [03]这种文件名,集号被解析成了 2,正则先撞上了“2 [”。整季的字幕全被当成同一集,还贴错了位置。现在解析集号前先把Season N抹掉。 -
文件夹叫“第一季”时认不出季号,因为正则只认阿拉伯数字。加了中文数字。
-
夸克接口时不时 SSL 握手失败,取字幕时每轮随机丢几条。改成最多跑 5 轮,把结果累积起来,连续两轮没有新增就停。
完结的任务要清掉
后来发现追更列表里挂着几个早就完结的番,没有截止日期,会永远挂下去。
现在下完会去查 TMDB。完结了(Ended / Canceled,或者这一季的集数已经全部播完)就把任务删掉;还在连载,就把截止日期设成完结日加 14 天;TMDB 查不到的,截止日期设成 90 天后,总之不许永久挂着。原来积下的 6 个完结任务也一并清了。
跟它说话
| 我说 | 它做 |
|---|---|
1 2 6 | 下刚才推荐的那几部 |
| 我想看 XXX | 在目录里模糊搜,只命中一部就直接下,多部就列出来让我选 |
| 推荐点修仙的 | 按类型推,中文类型词映射到 AniList 标签 |
| 给 XXX 加字幕 | 给已入库的番找简体外挂字幕,不重下视频 |
| 别再推 X | 加黑名单 |
每一行对应一个技能描述文件,agent 看描述决定调哪个,都是先回话、后台干活。
环境上的坑
这套东西跨了四层:我的电脑、NAS、容器、agent 用的那个系统用户。有几个坑和业务逻辑无关,纯粹是环境:
-
带中文的脚本经过 SSH heredoc 传到 NAS 会乱码,反斜杠也会被改。统一改成本地 base64 编码,传过去解码落盘再执行。
-
NAS 上非 root 用户直接跑
python3 /tmp/x.py是 Permission denied,要么 sudo,要么docker exec。 -
转存容器只挂了自己的配置目录,看不到媒体库。所以转存在容器里做,下载、改名、配字幕在宿主机做。
-
NAS 的 SSH 是经 frp 中转出来的,偶尔会断。断了别狂重试,会被 fail2ban 封,而且越封越久,等一会儿再连。
-
我电脑是 Windows,控制台是 GBK,
print带“〜”这种字符的番名直接报错。要么按字节写 stdout,要么只写文件。
后来(2026-11 补)
这篇是 6 月 18 日写的,之后又出过几次事,补在这里。
周五的推荐漏推
写完第二天就漏了一次。6 月 19 日的定时任务跑了,但调 Jellyfin 时拿到 401,脚本没有重试,直接崩了,那一周什么都没推,也没有任何报错通知。当时加了重试和失败告警。
7 月 10 日又是 401,这次才找到真正的原因。每周五 20:00,周推和每半小时一次的“看完触发”轮询同时启动,两个任务用同一个 DeviceId 登录 Jellyfin,而 Jellyfin 对同一个 DeviceId 重复登录会吊销前一个 token。日志里两次登录只差 114 毫秒。中间两周没出事,只是因为抢赢了。
改成每个任务用自己的 DeviceId,轮询也挪到了每小时的 05 分和 35 分。
《无职转生》第三季没下下来
那个分享的季号写在上一层文件夹名里,最里层的文件夹只有字幕组的名字。脚本只看最里层,认不出是第几季,就把它丢了,也不报错。现在认不出时会往上一层层看,并且只在那一层恰好只有一个季号标记时才采信,“S1+S2+S3+S4”这种合集名不算。
同一次还查出完结判定的一个 bug。判断连载用的是整部剧的 next_episode_to_air,第三季在播,早就播完的第一、二季也被判成连载,截止日期算出来是个已经过去的日子。quark-auto-save 对过期的任务直接跳过,转存永远不执行。
TMDB 的季和分享里的季对不上
《怪兽8号》的“第二季”在 TMDB 上是第一季的第 13–23 集。脚本按分享里的“第二季”建了 Season 02,文件叫 S02E13,改名时去查 TMDB 是 404,集名补不上。这次是手动挪回 Season 01 的。
10 月《青之箱》第二季是反过来的。分享里的文件名明确写着 S02E01,但 TMDB 当时把两季记成了一季。核查逻辑看到 TMDB 只有一季,就把这些文件改判成第一季;同时 autodl 把我说的“第二季”丢了,对着整个分享开下,而那个分享里第一季、第二季都有。我要的是第二季,收到的是第一季的转存通知。
改成:文件名里明确写了季号的,不许被 TMDB 或者大模型改判;autodl 加了 --season,说了哪一季就只碰哪一季,库里已经有的季跳过。
“集数全优先”反过来坑了一次
9 月 7 日收到《最强阴阳师的异世界转生记》的完成通知:18 集,976MB。这部番一共 13 集。
分享里除了两个字幕组的 13 集正片,还有一个 SPs 子文件夹,里面是 18 个一两分钟的 Mini Anime。选版本时“先看谁的集数全”,18 比 13 多,就选中了它。转存之后路径里的 SPs 没了,后面过滤非正片只看文件名,Mini Anime 又不在名单里,于是 18 个短片被当成 E01–E18 下了下来,前 13 个还套上了正片的集名。
改了三处:选版本时排除 SPs / OVA / OAD / Mini Anime / 小剧场 这类文件夹;转存任务只认核查时确认过的那批文件名;落盘前再滤一遍。
第二处又埋了个雷。任务规则写成了那批文件名的精确匹配,连载的番之后出的新集不在名单里,永远匹配不上。10 月 13 日改成只把文件名里的集号放开,字幕组、番名、季号、画质这些照旧卡死。
回了“已开始下载”,其实没跑
9 月 7 日,从 Windows 部署上去的 quark_ctl.py 换行符是 CRLF,shebang 那行变成了 python3\r,脚本根本启动不了。但后台 shell 的退出码是 0,agent 照样回了“已开始下载”。把换行符改回 LF 就好了。
观看时长攒够了
6 月时 Playback Reporting 里只有 9 条记录。10 月再看,7 月下旬到 10 月下旬有 517 条、134 个小时,其中动漫大约 120 小时。拿它更新了一遍给 agent 用的口味档案,按需推荐时它会先读这份档案。每周定时推荐用的打分脚本还是 6 月那套权重,没动。
另外有两部我看完的番正好落在 6 月口述的排除规则里,所以按需推荐时不再把那几条当硬规则。
开源
推荐这部分也整理出来开源了:
github.com/Fanxiaoyao66/anime-taste
协议 AGPL-3.0。口味权重不再写死,改成由 AI 读你的观看记录、再问你几个问题现场生成。打好标签的目录也一起放进去了,不用自己从头再打一遍,出处写在 README 里。
目录跟着原文档更新过几次,现在是 2435 部。新增的里面有十几部只查到了 TMDB 的类型,没有细标签。
下载那一层后来的事故记在上一篇文末。